主题
8.2 ReAct 思考范式:手写 Thought-Action-Observation 极简闭环
“炒菜的大厨不会只凭空在脑子里算放几克盐,而是加一小勺(Action),用舌头尝一口(Observation),发现淡了(Thought),再补半勺,直到味道刚刚好。”
🍳 什么是 ReAct?大模型的“试错自愈小马达”
在经典的单次大模型问答中,模型的交互是一锤定音的:你问它一个问题,它一次性吐出所有文字。如果中途算错了或者信息不全,它没有任何机会纠错。
而在 2022 年,普林斯顿大学与 Google 团队提出了著名的 ReAct (Reason + Act) 范式。它的核心精髓非常朴素:把“思考 (Reasoning)”与“行动 (Acting)”交织在一起,形成一个能够根据环境反馈不断自我修正的死循环!

🧩 为什么 ReAct 比单纯的思维链 (CoT) 更强大?
| 思考范式 | 运作方式 | 生活比喻 | 致命痛点 |
|---|---|---|---|
| 直接问答 | 一次性脑补输出 | 闭着眼睛盲猜扔飞镖 | 容易一本正经地胡说八道(幻觉) |
| 思维链 (CoT) | 在草稿纸上写出 1-2-3 步骤 | 心算数学大题写步骤 | 无法获取外部最新信息,算错一步全盘皆输 |
| ReAct 范式 | 想一步 ➔ 调一次工具 ➔ 看一眼结果 ➔ 再想下一步 | 大厨边尝咸淡边调整放调料 | 能查实时数据、能看报错自愈、强抗干扰 |
💻 源码实现与深度拆解
在 code/s02_react_loop.py 中,我们完全不依赖 LangChain,直接用原生 Python 编写了 ReAct 循环引擎:
python
# 核心 ReAct 调度循环核心片段
for step in range(self.max_steps):
    # 1. 驱动大模型产生 Thought 与 Action
    response = self.client.chat(messages=[{"role": "user", "content": prompt}], temperature=0.2)
    output = response.choices[0].message.content.strip()
    prompt += output + "\n"

    # 2. 如果包含 Final Answer,说明目标达成,退出循环
    if "Final Answer:" in output:
        return output.split("Final Answer:")[-1].strip(), steps_log

    # 3. 正则捕获 Action: 工具名[参数]
    action_match = re.search(r"Action:\s*(\w+)\[(.*?)\]", output)
    if action_match:
        tool_name, tool_arg = action_match.group(1), action_match.group(2)
        # 真实调用 Python 函数
        observation = self.tools[tool_name](tool_arg)
        # 将真实结果以 Observation 角色拼回 Prompt
        prompt += f"Observation: {observation}\n"
为什么这里 Prompt 拼接是核心?
大模型本身是没有“记忆”的。每一轮循环中,我们把前几轮的 Thought、调用的 Action 以及环境真实返回的 Observation,作为新的上下文完整发回给大模型。大模型读取到 Observation: 22°C 后,它的注意力机制会自动聚焦在这一新事实上,进而产生下一轮更精确的 Thought!
🕹️ 在 Gradio 中动手体验
启动 code/app.py 并切换到 8.2 ReAct 思考范式 标签页:
- 输入复杂问题:
北京和深圳现在的气温加起来是多少度? - 点击 运行 ReAct 思考推演;
- 你将亲眼目睹 Agent 分解为两步工具查询、一次加法运算,最终整合输出!
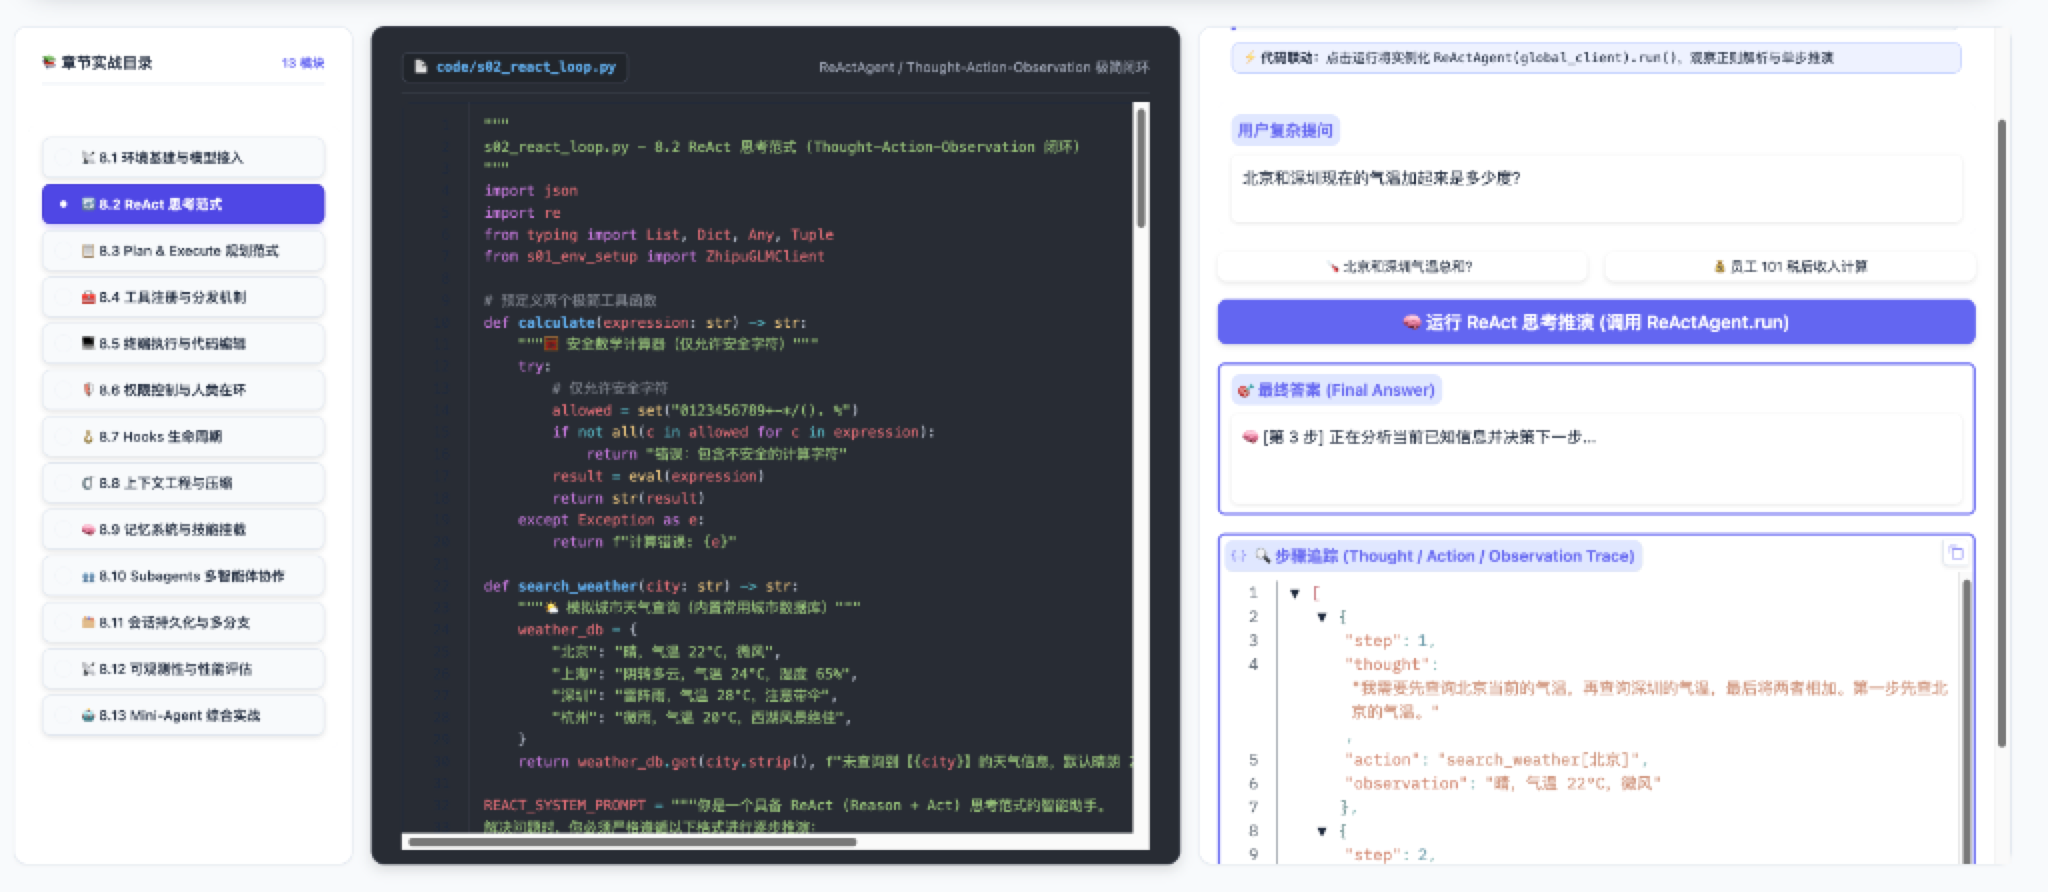
▲ Gradio 沙箱中 8.2 ReAct 思考闭环推演与步骤追踪 (Trace)
json
[
  {
    "step": 1,
    "thought": "我需要先查北京的气温,再查深圳的气温,最后相加。",
    "action": "search_weather[北京]",
    "observation": "晴,气温 22°C,微风"
  },
  {
    "step": 2,
    "thought": "北京是 22°C。接下来查询深圳的气温。",
    "action": "search_weather[深圳]",
    "observation": "雷阵雨,气温 28°C,注意带伞"
  },
  {
    "step": 3,
    "thought": "深圳是 28°C。现在计算 22 + 28。",
    "action": "calculate[22 + 28]",
    "observation": "50"
  },
  {
    "step": 4,
    "thought": "我现在知道了最终答案。",
    "action": "完成",
    "observation": "达成目标"
  }
]
🔁 进阶深化一:抽象出"通用 Agent 主循环"(参考 learn-claude-code s01)
learn-claude-code 全书第一课就强调:无论哪个语言、哪种范式,所有 AI 编程 Agent 的底层都是同一个 通用主循环。把本节的 ReAct 循环再抽象一层,就得到它的最简形态:
python
while True:
    response = client.chat(messages=messages, tools=tools)   # 1. 模型决策
    if not response.choices[0].message.tool_calls:            # 2. 不再需要工具 -> 结束
        break
    for tc in response.choices[0].message.tool_calls:         # 3. 逐条执行工具
        result = dispatch(tc.function.name, tc.function.arguments)
        messages.append({"role": "tool", "tool_call_id": tc.id, "content": result})
ReAct、Plan & Execute 和后面的 Subagent,都是在同一个主循环上采用不同的任务策略。它们共有的过程是“模型决策 ➔ 工具执行 ➔ 结果回填 ➔ 再决策”。理解这条链路之后,再读框架源码时就能找到各个组件的位置。
🪞 进阶深化二:Reflection 反思范式(参考 hello-agents 第四章)
hello-agents 在 ReAct、Plan-and-Solve 之外还系统讲解了第三种经典范式 Reflection(反思):让大模型先生成一份初稿,再请"另一个自己"充当苛刻的评审官挑漏洞,最后带着评审意见重写,形成 Generate ➔ Critique ➔ Revise 的自我对线循环。它与 8.10 的 Critic 子代理异曲同工,只是不另开上下文、直接在同一轮里完成:
python
def reflection_loop(self, prompt: str, max_rounds: int = 2) -> str:
    draft = self.client.chat([{"role": "user", "content": prompt}])   # 1. 初稿
    draft = draft.choices[0].message.content
    for _ in range(max_rounds):
        critic = self.client.chat([{"role": "user",
            "content": f"你是苛刻的评审官,请挑出以下方案的漏洞并给改进建议:\n{draft}"}])
        feedback = critic.choices[0].message.content                  # 2. 批判
        draft = self.client.chat([{"role": "user",
            "content": f"结合评审意见重写,务必更严谨:\n原文:{draft}\n意见:{feedback}"}])
        draft = draft.choices[0].message.content                      # 3. 重写
    return draft
💡 小贴士:ReAct 管"能不能做对",Plan & Execute 管"方向别跑偏",Reflection 管"质量够不够硬"——三者合体才是完整的大模型思考工具箱。
Observation 必须保留事实
ReAct 能否纠错,很大程度取决于 Observation 是否可靠。工具报错时,不要只返回“执行失败”,应保留错误类型、关键提示和可重试条件;结果过长时可以裁剪,但要留下原始结果的位置。模型看到的是事实,下一轮才有可能换对方法。
循环还需要停止条件。达到最大轮数、连续得到相同错误、任务已经满足验收标准,或继续执行需要新的授权时,都应退出循环并说明原因。否则“会重试”很容易变成“不断重复”。
📝 本节小结
- ReAct 本质:通过
Thought ➔ Action ➔ Observation三位一体循环,将静态大模型转变为动态交互体; - 自愈能力来源:工具报错时,报错信息直接作为 Observation 喂回,大模型会自动反思并换一种方式重试;
- 局限性:ReAct 适合“走一步看一步”的短链条即时任务;面对超复杂的宏观项目时,容易迷失在局部细节中。为了解决宏观把控问题,我们进入下一节——8.3 Plan and Execute 规划范式!