主题
8.13 综合实战:打造个人 Mini-Agent —— 会联网搜索、会深度思考的对话助手
“从 8.1 的一颗 CPU,到如今这台有眼睛(联网搜索)、有大脑(深度思考)、有手(工具调用)、有记性(记忆/技能)、有档案(会话存档)、有仪表盘(可观测)的完整智能体——就像组装一台电脑:零件我们一个个搓好了,今天把它们装成你的专属工作站!”
🏗️ 收官整合:一台属于你的「个人 Mini-Agent」
经过前面 12 节的逐个攻坚,我们已经把 Agent 的全部器官逐一搓好:
| 章节 | 搓好的"器官" | 在本节的角色 |
|---|---|---|
| 8.1 | ZhipuGLMClient 模型客户端 | 大脑与神经 |
| 8.2 - 8.3 | ReAct / Plan & Execute / Reflection 思考范式 | 思维模式 |
| 8.4 - 8.5 | 工具注册分发 + 终端 + str_replace | 手与脚 |
| 8.6 - 8.7 | 权限门禁 + Hooks 切面 | 安全带与监控 |
| 8.8 - 8.9 | 上下文压缩 + 记忆 + 技能挂载 | 内存与经验 |
| 8.10 | Subagents 子代理协作 | 团队分工 |
| 8.11 | 会话持久化与多分支 | 存档读档 |
| 8.12 | 可观测性与评估 | 仪表盘 |
本节是 收官实战:我们把所有器官组装成一台 个人 Mini-Agent——一个能陪你长期对话的 AI 助手,并新装上两大"王牌能力":
- 🌐 联网搜索(Web Search):不再局限于模型训练时的旧知识,随时检索最新资讯、数据、文档;
- 🧠 深度思考(Deep Thinking):面对复杂问题时,先"想清楚再回答"——应用层的"先规划后执行"(多发一次规划调用),默认仍用主模型,可选接 GLM-R1 深度推理端点(详见下文"诚实辨析")。

🌐 新能力一:手写会诚实报错的 web_search
大模型的训练数据有截止日期,天然无法回答"今天发生了什么"。"联网搜索"就是把 Agent 的眼睛接到真实世界。我们选用 DuckDuckGo 的 HTML 接口(无需申请任何 API Key),用标准库 urllib 直接抓取、正则解析,符合"手搓"精神:
python
class WebSearch:
    """🔍 联网搜索:DuckDuckGo HTML 接口(免 API Key),返回 标题+链接+摘要"""
    BASE_URL = "https://html.duckduckgo.com/html/?q={query}"
    HEADERS = {"User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36"}

    def search(self, query: str, max_results: int = 5) -> str:
        try:
            url = self.BASE_URL.format(query=urllib.parse.quote(query))
            req = urllib.request.Request(url, headers=self.HEADERS)
            html = urllib.request.urlopen(req, timeout=12).read().decode("utf-8", "ignore")

            # 分别抓取「标题+跳转链接」与「摘要」
            titles = re.findall(r'class="result__a"[^>]*href="([^"]+)"[^>]*>(.*?)</a>', html, re.S)
            snippets = re.findall(r'class="result__snippet"[^>]*>(.*?)</a>', html, re.S)

            results = []
            for i, (href, title) in enumerate(titles[:max_results]):
                # DuckDuckGo 的链接是 uddg= 重定向参数,需解码还原真实 URL
                real_url = urllib.parse.unquote(re.sub(r".*uddg=([^&]+).*", r"\1", href))
                clean_title = re.sub(r"<.*?>", "", title).strip()
                snippet = re.sub(r"<.*?>", "", snippets[i]).strip() if i < len(snippets) else ""
                results.append(f"### {i + 1}. {clean_title}\n{real_url}\n{snippet[:150]}")
            return "\n\n".join(results) if results else "未检索到结果,请换个关键词再试。"
        except Exception as e:
            # 报错即观测:把错误转成文本喂回给模型,让它换思路
            return f"❌ [web_search 报错] {e}。若在当前网络下无法访问,可更换搜索源或改走本地知识。"
要点拆解:
- 免 Key 免依赖:纯
urllib + re,无需申请搜索 API,适合教学与本地跑通; - 报错即观测:联网失败时把错误转成结构化文本返回,模型会自动反思、换个思路;
- 可插拔:若 DuckDuckGo 不可达,只需替换
search()内部抓取逻辑,MiniAgent无需改动;当前实现会明确返回失败,绝不会拿固定文字冒充实时搜索结果。
🤔 生产环境一般用什么搜索 API?DuckDuckGo 只是兜底
真实项目里,Agent 的联网搜索通常接入专为 LLM 优化的搜索 API,而不是自己去爬 HTML。下表是主流方案:
| 方案 | 特点 | 是否需要 Key | 适用场景 |
|---|---|---|---|
| Tavily | 专为 LLM 设计的搜索 API,直接返回结构化摘要 | 需要(有免费额度) | 最常见的 Agent 搜索标配 |
| SerpAPI / Serper | 封装 Google / 必应搜索结果 | 需要 | 想复用搜索引擎结果 |
| Bing Web Search API | 微软官方,国内可达性较好 | 需要 | 国内环境更友好 |
| Brave Search API | 隐私友好,有免费额度 | 需要 | 轻量替代方案 |
| 国内搜索 API(如百度/腾讯云等) | 合规、低延迟 | 需要 | 国内生产部署 |
| DuckDuckGo HTML(本项目) | 零成本、免 Key、纯标准库,但页面结构易变 | 不需要 | 教学 / 本地链路演示 |
本项目选择 DuckDuckGo HTML 是零成本教学方案。网络失败或解析不到结果时,它只返回可识别错误,不生成看似可信的“实时摘要”。生产环境应换成带 SLA 和结构化响应的搜索 API。
🧠 新能力二:deep_think 深度思考前置规划(参考 deepagents 规划 + ReAct)
普通的对话是"拿到问题 → 直接回答",容易凭直觉、抓不住重点。工业界两条成熟思路恰好能补上这一环:
- deepagents 的"先规划、再执行":内置
write_todos规划工具,先把复杂目标拆成可执行的步骤清单再逐项执行——先有作战地图,再上战场; - 8.2 的 ReAct 范式:Thought(想)→ Action(做)→ Observation(看),每一步行动前先想清楚"我要做什么、为什么"。
我们把两者融合成一次深度思考前置规划:先用深度模型(可指定 GLM-R1 端点)产出"问题本质 + 检索计划 + 思考路径"的结构化作战清单,注入上下文后,让后面的 ReAct 工具循环每一步都有明确依据:
python
def deep_think(self, question: str) -> str:
    """🧠 深度思考前置规划器(参考 deepagents write_todos + 8.2 ReAct 先想后做)"""
    prompt = f"""请以"先规划、再执行"的方式对以下问题做深度思考,输出结构化规划(不超过 300 字):
1. 📌【问题本质】这个问题的核心矛盾 / 关键点是什么?
2. 🗺️【检索计划】为严谨回答它,需要检索哪些最新或外部信息?(列出 2-3 个候选检索关键词)
3. 🧭【思考路径】可能的论证路径与结论预判。
问题:{question}"""
    res = self.client.chat(
        [{"role": "user", "content": prompt}],
        model_endpoint=self.thinking_endpoint,   # 可传 R1 端点,也可复用主端点
        temperature=0.4,
    )
    return res.choices[0].message.content.strip()
python
# 在 chat() 主循环中,把"作战清单"以 system 角色注入,ReAct 循环据此行动
if deep_think:
    think = self.deep_think(user_input)
    self.bus.emit(AgentEvent("deep_think", content=think))   # 8.12:事件可观测
self.messages.append({"role": "system", "content": f"【🧠 深度思考前置规划】\n{think}"})一句话:深度思考负责"想清楚仗怎么打",ReAct 循环负责"一枪一弹地打"——前者是 deepagents 的规划器思想,后者是 8.2 的行动循环,两者合体才是完整的作战体系。
⚠️ 诚实辨析:这里的"深度思考"≠ 模型的"思考开关"
必须说清楚:本节的 deep_think 是应用层的"先规划后执行"——多发起一次普通 LLM 调用产出规划文本,模型本身没有开启任何原生思考能力。它与智谱 API 原生的思考模式(请求参数 extra_body={"thinking": {"type": "enabled"}},模型在回答前生成真正的隐式思维链,即 8.1 chat() 里那个 thinking 参数)是两个维度的东西:
| 对比 | 本节的 deep_think 前置规划 | 模型原生思考开关(8.1 的 thinking 参数) |
|---|---|---|
| 机制 | 应用层多跑一次"规划 prompt",把产出当上下文注入 | API 请求参数,模型内部生成隐式思维链后再作答 |
| 调用次数 | 2 次(规划 + 主回答) | 1 次 |
| 规划内容可见? | 可见(就是一条 system 消息,时间线里能看到全文) | 不可见(隐式 CoT) |
| 换模型吗? | 不换。thinking_endpoint 参数默认为 None 时复用主模型——当前代码没有接 GLM-R1,两次调用都是 glm-5.3-flash | 同一个模型开启内部思考 |
所以勾选 🧠 深度思考后,后端发生的事情是:同一个模型被调用了两次,第一次要它"输出作战清单",第二次带着清单正式回答。它提升答案质量靠的是"先规划再执行"的提示工程结构,而不是更强的推理模式。想接真正的深度推理端点,给
MiniAgent(client, thinking_endpoint="glm-r1-接入点")传参即可,代码已预留。
🎛️ 对话设置面板:四个开关背后发生了什么(后端机制盘点)
Web 工作台「对话设置」里的每个勾选项,都不是切换不同的 LLM——模型始终是同一个 glm-5.3-flash。它们改变的是"发给模型的上下文"和"工具权限",后端对应四条完全不同的路径:
| 开关 | 后端实际动作 | 生效时机 |
|---|---|---|
| 🧠 深度思考 | 如上:多发一次规划调用,规划文本以 system 消息注入消息列表。规划只在勾选的那一轮生成并注入:不勾选的轮次不会新增规划,但上一轮的规划文本仍留在消息列表里继续作为上下文(直到 /compact 压缩把它提炼进摘要,或 /clear 重开会话);再次勾选时,代码会先移除旧规划再注入新规划,保证列表里最多只有一条【最新规划】,避免模型按几轮前的过时计划行动 | 每轮勾选即生效;规划消息会跨轮残留,重新勾选时自动替换为最新 |
| 🔍 强制联网搜索 | 仅注入一条 system 消息("用户要求你优先调用 web_search……")。代码层面不强制调用——模型收到提示后自己决定是否调 web_search 工具(该工具本身只是抓取 DuckDuckGo 页面,不涉及模型) | 每轮勾选即生效 |
| 🧩 技能挂载 | 把 skills/<名称>/SKILL.md 的内容读出来,在会话首轮组装 System Prompt 时拼接进去(8.9 assemble_system_prompt) | ⚠️ 仅首轮生效——System Prompt 只在 messages 为空时组装一次,会话中途勾选对当前会话不生效,新建/清空会话后勾选才有效 |
| 💾 允许保存偏好 | 完全不碰模型。每轮重新绑定权限门禁的审批回调:勾上 = 本轮放行 save_preference 这一个工具;不勾 = 模型调用它会被拒绝("操作被人类管理员取消")。这是 8.6 最小权限设计 | 每轮重新绑定,取消勾选立即失效 |
教学要点:四个开关对应了给模型"注入影响"的四种典型手段——前置规划调用、system 消息、System Prompt 拼接、工具权限门禁。前两种每轮动态生效,第三种受"首轮组装"约束,第四种与模型无关、纯工程侧控制。理解这四条路径,比记住勾选项本身重要得多。
💻 组装与运行:MiniAgent 对话主循环
完整代码见 code/s13_mini_agent.py。MiniAgent 把所有器官焊在一起,对外只暴露一个 chat(user_input, deep_think) 多轮对话接口:
python
class MiniAgent:
    def __init__(self, client, memory_file="agent_memory.json", skills_dir="skills",
                 thinking_endpoint=None, session_store=None, session_id=None,
                 human_approval_callback=None):
        self.client = client
        self.thinking_endpoint = thinking_endpoint or client.default_model  # 🧠 深度思考端点(默认复用主力模型)
        self.registry = ToolRegistry()                      # 8.4 🧰 工具注册分发
        self.guard = PermissionGuard(...)                    # 8.6 🛡️ 权限门禁
        self.hooks = create_default_hook_manager()           # 8.7 🪝 Hooks 切面
        self.context_mgr = ContextManager(client, ...)       # 8.8 🗜️ 上下文压缩
        self.memory = MemoryStore(memory_file)               # 8.9 💾 长期记忆
        self.skill_loader = SkillLoader(skills_dir)          # 8.9 🎒 技能挂载
        self.web = WebSearch()                               # 🌐 联网搜索(兜底方案)
        self.bus = EventBus()                                # 8.12 📡 可观测事件总线
        self.session_store = session_store                   # 8.11 🗂️ 会话仓库(可选)
        self.session_id = session_id
        self.messages = []                                   # 💬 多轮对话上下文
        if self.session_id and self.session_store:
            node = self.session_store.load(self.session_id)
            if node and node.messages:
                self.messages = node.messages                # 📂 断点续跑
        self._register_default_tools()

    def chat(self, user_input, deep_think=False, active_skills=None):
        """💬 对话主循环:深度规划 → ReAct 工具循环 → 回答 + 可观测轨迹"""
        # 1. 首次对话注入记忆与技能(8.9)
        # 2. 深度思考前置规划(deepagents 思想,可选)
        # 3. while True: ReAct 主循环(8.2)
        #    模型决策(8.1) → 工具调用(8.4) → 门禁(8.6) → Hooks(8.7) → 截断(8.8)
        #    → 回填 → 事件广播(8.12),结束时自动存档(8.11)
        ...
这套 chat() 其实就是 8.2 的通用 Agent 主循环的完整工业形态——所有前序能力以"插件"方式挂载在循环里,一个器官都没有浪费。
✨ 输出适配:Markdown 润色:大模型的回答是"原生态" Markdown,常有
##标题缺空格、连续空行、代码围栏未闭合等小毛病。MiniAgent在给出最终回答前会经过polish_markdown()统一润色——自动补全标题空格、压缩多余空行(代码块内部空行原样保留)、配对闭合代码围栏并规整首尾空白,保证终端与网页都能得到干净规范的排版。
🧵 本章如何串起 1-12 章的全部知识点?
| 章节知识点 | 在个人 Mini-Agent 中的落点 |
|---|---|
| 8.1 模型客户端 | ZhipuGLMClient 统一对话 / 流式入口 |
| 8.2 ReAct 范式 | chat() 的 Thought-Action-Observation 主循环 |
| 8.3 规划范式 | deep_think() 深度思考前置规划器(融合 deepagents 思想) |
| 8.4 工具注册分发 | ToolRegistry + @register 五件套工具 |
| 8.5 终端与编辑 | exec_bash / read_file / edit_file_replace |
| 8.6 权限门禁 | PermissionGuard 高危拦截 + [y/N] 人类审批 |
| 8.7 Hooks 切面 | Pre/Post 钩子:计时 + 敏感信息脱敏 |
| 8.8 上下文压缩 | ContextManager 自动 /compact + 长结果截断 |
| 8.9 记忆与技能 | MemoryStore 偏好记忆 + SkillLoader 技能注入 |
| 8.10 子代理 | 深度调研时可接入 DeepResearchPipeline(可选) |
| 8.11 会话持久化 | SessionStore 自动存档 + 断点续跑 |
| 8.12 可观测性 | EventBus 全流程事件轨迹(trace 可直接回放) |
从 8.1 到 8.12,每一个器官都在这台个人 Mini-Agent 上真正"上岗"了——这正是本章取名综合实战的意义。
🕹️ 动手体验
方式一:命令行交互式对话(推荐先试这个)
bash
cd 08_手搓Agent/code
uv run python s13_mini_agent.py --repl    # 交互式多轮对话(REPL,流式打字机输出)
uv run python s13_mini_agent.py           # 不加参数:只跑一条内置的单轮演示问题
--repl 模式是一个带命令菜单的交互式终端界面:启动时先打印一个大大的绿色 ASCII Logo(仿 Codex 风格),输入 / 会弹出命令候选菜单(↑↓ 选择、Tab 补全),按 ↑↓ 可翻阅输入历史;回答以流式打字机逐字输出(接入 8.1 chat_stream);每一步动作都会通过 8.12 的 EventBus 实时打印状态行(🤔 模型思考中 → ⚙️ 调用工具 → 🛡️ 权限门禁 → 🏁 完成),让你亲眼看到 ReAct 循环的每一次心跳。命令细节不再印在启动屏上——输入 / 看菜单,或输 /help 查完整清单:
███╗   ███╗██╗███╗   ██╗██╗
████╗ ████║██║████╗  ██║██║
██╔████╔██║██║██╔██╗ ██║██║
██║╚██╔╝██║██║██║╚██╗██║██║
██║ ╚═╝ ██║██║██║ ╚████║██║
╚═╝     ╚═╝╚═╝╚═╝  ╚═══╝╚═╝

 █████╗  ██████╗ ███████╗███╗   ██╗████████╗
██╔══██╗██╔════╝ ██╔════╝████╗  ██║╚══██╔══╝
███████║██║  ███╗█████╗  ██╔██╗ ██║   ██║
██╔══██║██║   ██║██╔══╝  ██║╚██╗██║   ██║
██║  ██║╚██████╔╝███████╗██║ ╚████║   ██║
╚═╝  ╚═╝ ╚═════╝ ╚══════╝╚═╝  ╚═══╝   ╚═╝
个人 Mini-Agent · 会联网搜索、会深度思考的对话助手(8.13 综合实战)

💡 输入 / 即弹出命令菜单,↑↓ 翻历史记录,Tab 补全

👤 You> /search 2026年最新的主流前端框架有哪些新趋势?
  🚀 开始处理 /search 2026年最新的主流前端框架有哪些新趋势?
  🤔 模型思考中 耗时 1523ms
  ⚙️ 调用工具 web_search → {"query": "2026 前端框架新趋势"}
  🛡️ 权限门禁 [SAFE] 🟢 [自动放行] 只读/检索工具 [web_search],无系统写入动作
  ✅ 工具返回 web_search ← ### 1. React 19 发布 ...
  🏁 完成
🤖 Agent>
根据最新资料,2026 年前端领域主要有三大趋势:……

📊 Token 消耗 [glm-5.3-flash] 输入 1240 / 输出 386 / 总计 1626 | 缓存命中 640(命中率 51.6%)
💡 状态行不是"演出效果":它们全部来自
MiniAgent内部bus.emit()广播的真实事件(8.12 可观测性),CLI 只是通过bus.subscribe("*", ...)通配订阅后实时打印——与 Web 端决策流 Trace 是同一份数据源。🗂️ 会话自动存档:CLI 对话通过 8.11 的
SessionStore自动写入code/sessions/<session_id>.json,退出程序后可用/sessions查看全部存档、/resume 1恢复任意会话继续对话(跨进程断点续跑)。
方式二:Gradio 工作台
🧪 这是真实模型对话,不是 Mock 聊天:每次发送都会调用
ZhipuGLMClient;Agent 决定搜索或勾选"强制联网搜索"时,还会尝试访问真实 DuckDuckGo 搜索页面。请先配置ZHIPU_API_KEY,并留意多轮对话、深度思考与工具回填都会增加 Token 消耗。
Gradio 有两个入口,随你取用:
入口 A:独立 Mini-Agent 工作台(推荐新手,专注 8.13 一件事)
bash
cd 08_手搓Agent/code
uv run python app_s13.py    # 浏览器打开 http://127.0.0.1:7861
单页专注版工作台:左侧 ChatGPT 风格多轮气泡对话(回答流式逐字增长),右侧是实时状态时间线——发送消息后,Agent 的每一步动作(🧠 深度思考 → ⚙️ 调用 web_search → 🛡️ 权限门禁 → ✍️ 流式输出 → 🏁 完成)会逐行实时滚动显示,顶部还有当前状态徽章。顶部工具条支持会话切换:对话自动存档至 sessions/,下拉选择历史会话即恢复全部气泡,也可一键新建会话。底部保留决策流与权限门禁审计 Trace 原始 JSON。
入口 B:13-Tab 全景教学工作台
在 code/app.py 中切换到 8.13 Mini-Agent 综合实战 标签页:
- 输入多轮连续问题,例如先告诉它自己的名字和偏好,再提问确认长期记忆;
- 勾选 🔍 强制联网搜索 或 🧠 深度思考 开关,或挂载
git_expert/python_cleaner技能插件;若要保存长期偏好,还需显式勾选"允许本轮保存偏好",该授权不会放行终端或代码编辑。四个开关各自改的是什么(system 注入 / 首轮 System Prompt 拼接 / 权限回调,而非切换 LLM),见上文「对话设置面板:四个开关背后发生了什么」; - 点击 🚀 发送,观察支持多轮气泡对话流的完整 Mini-Agent 实时作答,并可在底部展开决策流与权限门禁审计 Trace!
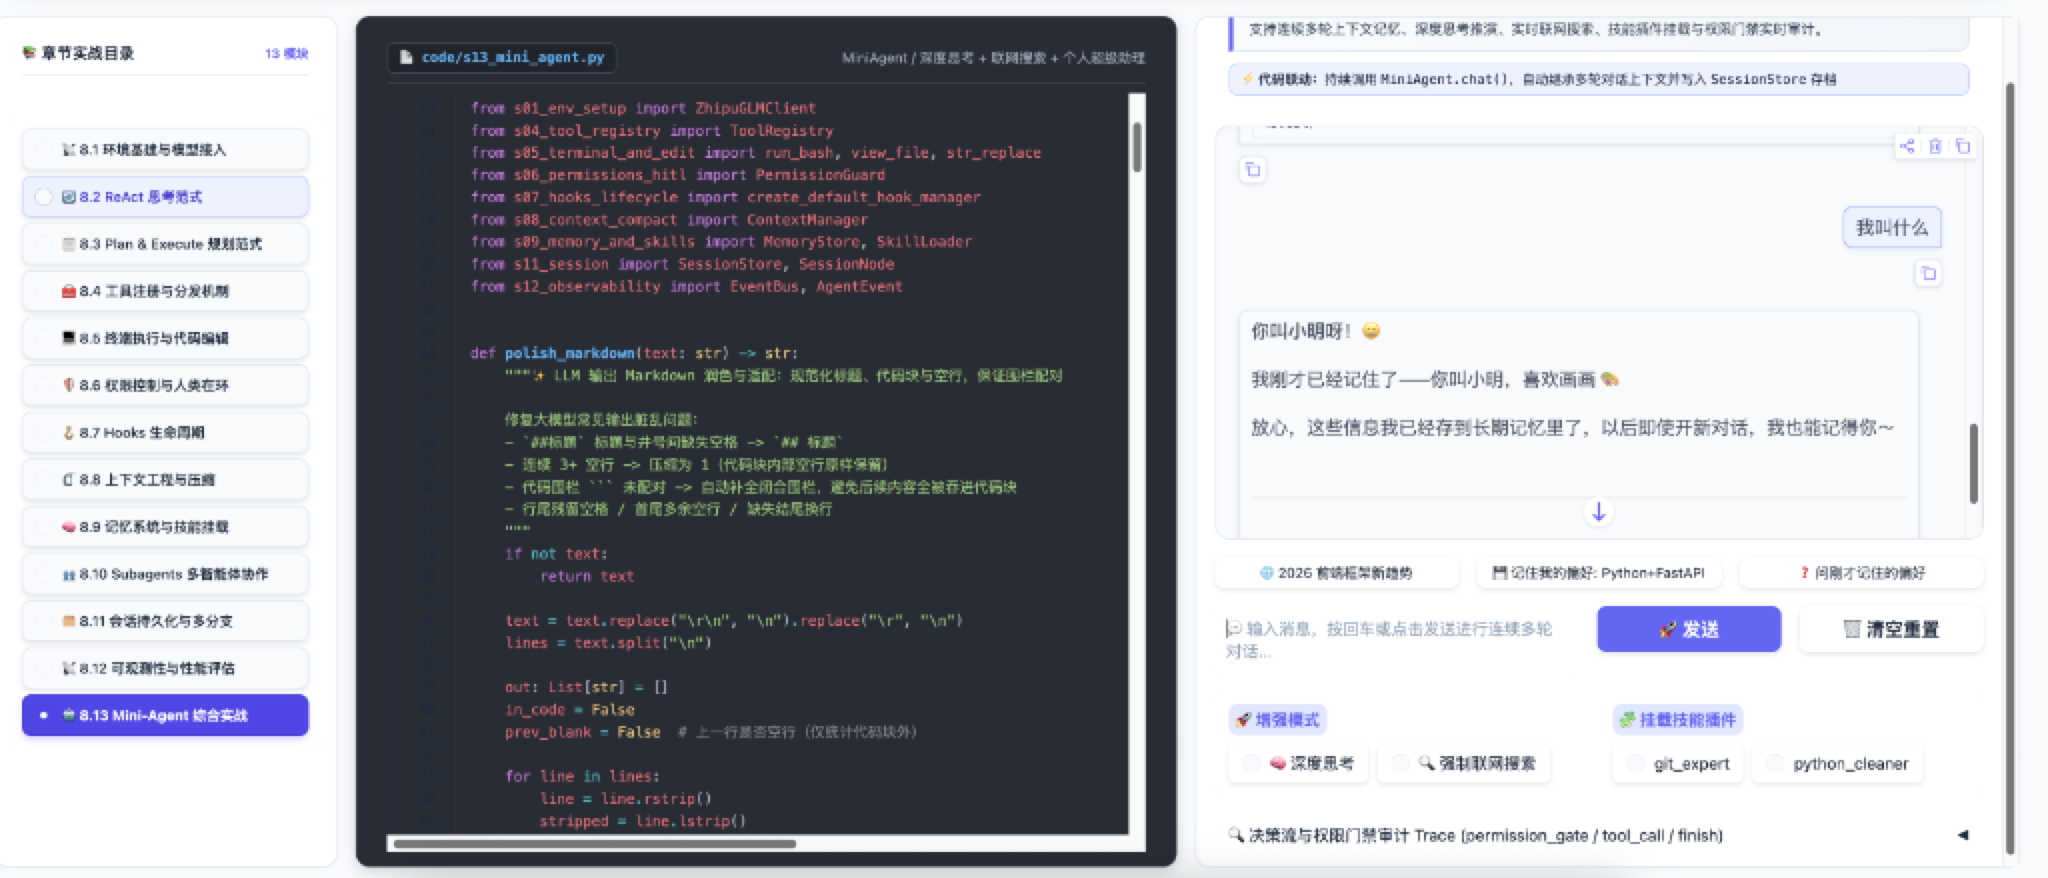
▲ Gradio 工作台中 8.13 Mini-Agent 连续多轮上下文记忆、深度思考与联网搜索综合实战
🧭 项目盘点:诚实清单——已实现什么?还没实现什么?
至此,第八章收官。这一节不做任何美化,逐项对账。
✅ 已经实现的(全部经过真实模型验证)
| 能力 | 实现方式 | 验证状态 |
|---|---|---|
| 多范式思考内核 | ReAct(8.2)/ Plan & Execute(8.3)/ Reflection | 单节脚本 + 工作台可复现 |
| 全链路工具生态 | @tool 自动 Schema、终端执行、str_replace、联网搜索(8.4/8.5) | 真实调用验证 |
| 安全与可控 | 三级权限门禁 + HITL 审批回调 + Hooks 脱敏 + LoopGuard 熔断(8.6/8.7) | 实测拦截 exec_bash 写文件并优雅降级 |
| 上下文工程 | 滑动窗口截断 + /compact 深度摘要(8.8) | 工作台可观察 |
| 记忆与技能 | MemoryStore 长期偏好 + SKILL.md 挂载(8.9) | 真实模型读写验证 |
| 子代理协作 | 深度研究流水线(8.10,串行) | 工作台可复现 |
| 会话持久化与切换 | SessionStore 自动存档 + CLI /sessions /resume 跨进程续跑 + Web 下拉切换(8.11) | 浏览器实测通过 |
| 可观测性 | EventBus 全流程事件:CLI 实时状态行 / Web 实时状态时间线 / Trace JSON 回放(8.12) | 同一数据源三端一致 |
| 流式输出(新) | 接入 8.1 chat_stream:CLI rich Live 打字机 + Web 气泡逐字增长(正文轮);工具轮自动降级非流式重放拿结构化 tool_calls | 真实模型双路径验证 |
| CLI 交互界面(新) | prompt_toolkit:输入 / 弹命令菜单(↑↓ 选择 / Tab 补全)+ 输入历史持久化 | 伪终端验证 |
| 可视化工作台 | app.py 13-Tab 全景 + app_s13.py 独立专注版(流式 + 会话切换 + 实时时间线) | 浏览器实测通过 |
⚠️ 还没实现的(不要被界面"像"迷惑)
界面长得像 ChatGPT/Claude Code ≠ 能力对齐。以下是如实差距:
- 没有 Workspace(工作区隔离):Agent 直接跑在本机当前目录,没有根目录约束、没有按任务的文件系统边界——Claude Code 的"每个任务一个 workspace"我们完全没有;
- 没有真沙箱:
exec_bash靠 8.6 的规则拦截(白名单/高危正则/审批),不是容器或 microVM 级隔离,绕过方式很多,不可用于不可信代码; - 没有会话并行:一次只有一个 Agent 实例在工作,无法同时跑多个任务互不干扰;
- 长期记忆全局共享:单个
agent_memory.json,没有按会话/项目分区,跨任务可能互相污染; - 没有 MCP 生态:工具全是手搓注册,未接入 Model Context Protocol 工具服务器;
- 没有评测闭环:8.12 有
EvalSuite雏形,但没有基准集、没有回归流水线、没有放进 Harness 持续跑; - 工具轮流式是"伪流式":正文轮逐字输出,但工具调用轮需非流式重放拿结构化 tool_calls(s01 流式接口不透出 tool_calls 片段),多轮工具任务仍是"执行时等待";
- 无团队通信:子代理串行传参,没有 A2A 异步消息协议。
🔬 深度对比:与 Codex / Claude Code 还差什么?
把本项目放到真实产品旁边量一量(截至 2026 年,产品形态变化快,以官方文档为准):
| 维度 | 本项目(教学 Mini-Agent) | OpenAI Codex CLI(开源,Rust) | Claude Code |
|---|---|---|---|
| 沙箱执行 | 规则拦截,无隔离 | OS 级沙箱(macOS Seatbelt / Linux Landlock),网络与文件默认禁出 | 容器/沙箱执行环境 + 权限模式 |
| 工作区 | 无概念,当前目录即世界 | Git 仓库感知 + 沙箱内工作区 | 工程级上下文 + 文件边界 |
| 权限模型 | 三级门禁 + 回调审批(教学级) | 审批模式(suggest/auto-edit/full-auto)+ 沙箱兜底 | 权限模式 + 允许清单 + HITL |
| 上下文工程 | 截断 + 摘要压缩 | 自动压缩 + 大上下文模型 | 自动 /compact + CLAUDE.md 记忆 |
| 子代理 | 串行流水线 | 单代理为主 | 真子代理并行(Task 工具) |
| 工具生态 | 5 个手搓工具 | 内置 + MCP 接入 | 内置 + MCP 接入 |
| 评测 | EvalSuite 雏形(未进 CI) | 内部大规模 Eval Harness | 内部 Eval 体系 |
| 稳定性工程 | 单进程、无重试背压 | 生产级(重试/降级/断点) | 生产级 |
核心差距总结成一句话:我们实现了 Agent 的"骨架与器官"(思考范式/工具/门禁/记忆/会话/观测),但缺少"骨骼外面的皮肤和免疫系统"——沙箱隔离、工作区边界、生产级可靠性、工具生态与评测闭环。这正是从教学项目到可用产品的距离,也是后续开发的路线图。
📚 面向生产的进阶参考(全部为可点击的官方/权威链接)
沙箱隔离的几种生产级方案(按隔离强度从高到低):
| 方案 | 隔离机制 | 一句话定位 | 官方链接 |
|---|---|---|---|
| Firecracker | microVM(KVM 虚拟化) | AWS 开源的轻量 VMM,启动 <125ms、每 VM 内存开销 <5MiB,Lambda/Fargate 同款 | firecracker-microvm.github.io |
| gVisor | 用户态内核(拦截 syscall) | Google 的应用内核沙箱,runsc 运行时直接替换 Docker 的 runc,无需改应用 | gvisor.dev |
| microsandbox | 本地 microVM | 本地优先的自托管 microVM 运行时,类 Docker 体验、专为不可信 AI 负载设计 | github.com/microsandbox/microsandbox |
| E2B | 托管云沙箱(Firecracker 上层封装) | 为 Agent 按需创建云端隔离 VM 执行代码,两行 SDK 接入,免自建 | docs.e2b.dev |
| OS 原生沙箱 | OS 级访问控制 | macOS Seatbelt(sandbox-exec)/ Linux Landlock、seccomp——Codex CLI 采用的路线 | github.com/openai/codex |
选型直觉:自建基础设施选 Firecracker/gVisor;本机自托管选 microsandbox;不想运维选 E2B;桌面工具选 OS 原生沙箱。教学项目第一步只需 Docker + 8.6 门禁收紧,就已经超过"裸跑本机"。
MCP 接入:不必手写协议,用 FastMCP(Prefect 维护的 Python 框架,约 27.5k stars,FastMCP 1.0 已并入官方 MCP Python SDK)——用普通 Python 函数声明工具,Schema/校验/文档自动生成:github.com/jlowin/fastmcp 、MCP 官方规范。
评测要放进 Harness:评测不是"跑一次的脚本",而是工程化的持续评估体系——基准数据集版本化 + 每次改动自动回归 + 成功率/时延/成本三指标看板。可参考 learn-claude-code 的 Eval 思路与本仓库 8.12 的 EvalSuite 雏形对接 CI。
🗺️ 本项目后续开发方向(建议的开发范式)
想把这个教学项目往"可用产品"推进,比"写什么代码"更重要的是"怎么开发"。结合本章实测经验,给出四条工程建议:
1. 用 Git 分支流隔离实验:能运行的 main 分支始终保持可演示;每个新功能(如沙箱、MCP)开独立分支实现,Review 通过后再合并。绝不直接在可用版本上大改——本章任何一次"顺手重构"都可能弄坏演示现场。
2. 分阶段开发 + 每阶段 Review:一个大功能(比如"接入 MCP")拆成可独立验收的小步:M1 读 MCP 规范 → M2 用 FastMCP 跑通第一个 echo 工具 → M3 替换 MiniAgent 的手搓注册 → M4 工作台可视化 MCP 工具。每阶段结束做一次人工验收,出问题立刻止损,不要一次性实现一个大功能。
3. 采用 OpenSpec + ATDD 的开发范式:
- OpenSpec(Fission-AI):Spec 驱动开发(SDD)工具——动代码前,AI 先产出
proposal.md(为什么做)、specs/(需求,SHALL/WHEN/THEN 格式)、design.md(技术方案)、tasks.md(任务清单)四件套,人审查共识后再让 AI 依清单实现,最后归档。让"AI 写代码"从碰运气变成可审查的流程; - ATDD(验收测试驱动开发):先写验收测试(如"危险命令必须被拦截且返回可解释信息"),再写实现——本章的完成标准清单就是现成的验收用例来源,可直接转成 pytest 断言。
4. AGENTS.md 瘦身,分阶段注入规则:根目录 AGENTS.md 不要超过 150 行——它是 AI 协作的"宪法",只放不变的原则(写作规范、Git 纪律、目录结构);每个阶段特有的规则(如沙箱阶段的容器安全守则、评测阶段的基准集约定)放进对应子目录的局部说明文件,AI 进入该目录工作时不读也会迷路的内容就不要全局携带。
后续功能路线建议(按依赖顺序):
- 评测先行:把完成标准转成 pytest + 基准集,接进 CI——没有评测闭环,后面每个功能都是"感觉能用";
- Workspace 隔离:给
MiniAgent加workspace参数,约束exec_bash/文件工具的根目录,每会话独立记忆文件; - MCP 接入:用 FastMCP 把 5 个手搓工具迁到 MCP 服务器,工具生态一次打通;
- 沙箱执行:先用 Docker 限定
exec_bash,进阶再上 microsandbox/Firecracker; - 子代理并行:8.10 流水线改异步(
asyncio),解锁多任务并发。
📚 后续深入学习路线(强烈推荐)
- learn-claude-code(shareAI-lab):本项目的灵感源泉,12 个阶段把 Claude Code 从 84 行搓到 694 行,值得逐阶段精读,尤其补上我们缺的"任务依赖 / 后台任务 / 团队通信协议 / 自治看板";
- DeerFlow(GLM 开源的深度研究框架):研究"规划 → 检索 → 反思"的深度研究工作流是如何在工业级工程里落地的,是我们 8.10 DeepResearch 流水线的完整版参考;
- hello-agents(Datawhale):第 8-12 章的记忆/RAG、上下文工程、通信协议、Agentic-RL、性能评估,补齐理论纵深。
🔧 如果想做"属于自己的 Agent",建议二次开发基座
不必从零再搓一遍——在以下开源基座上做二次开发效率最高:
- opencode(sst 团队):TypeScript 开源 Agent,CLI + TUI + 多模型,你在第 5 章已经玩过它——加自己的工具、Skills、命令都极其顺滑;
- Pi(earendil-works/pi):Mario Zechner 打造的最小核心 Agent 框架,只有 read/write/edit/bash 四个原子工具,MIT 协议,最适合"按自己口味长成任何形状";
- GLM Harness(GLM 官方 Agent 脚手架):与本章同源的国产模型底座,适合在此基础上接入自家业务、私有模型与评测体系。
一句话收尾:能手搓,就一定能魔改。看懂原理之后,无论用哪个基座,你都能玩出自己的花样。
给 Mini-Agent 写一份完成标准
综合项目容易出现“功能都接上了,却不知道是否可用”的情况。可以用一组固定任务验收:普通问答不调用工具;需要文件时先读后改;危险命令会被拦截;中断后可以恢复;上下文超限能压缩;工具失败会留下错误原因;最终回答能指出证据与验证结果。
还应主动测试失败路径,例如无效密钥、超时、损坏的会话文件、工具返回超长内容和用户拒绝审批。一个 Agent 在顺利环境中跑通只是起点,能够在失败时停在可解释、可恢复的位置,才具备继续扩展的基础。
🏁 第八章完:从 API 使用者到 Agent 构建者
从 8.1 的第一次 API 调用,到 8.13 这台能够搜索、调用工具、保存会话并记录运行过程的 Mini-Agent,你已经走过了一次完整的智能体构建过程:
- 看透黑盒:你亲手写过每一行请求报文、每一个工具 Schema、每一处循环调度;
- 掌握范式:ReAct / Plan&Execute / Reflection 的取舍了然于心;
- 具备工程观:权限、切面、压缩、记忆、并发、观测——工业级 Agent 的骨架你都搭过一遍。
理解这些运行环节之后,再学习 LangChain、LangGraph、CrewAI 等上层框架,就能分辨每个接口替我们封装了什么。下一章进入 第九章:LangChain 搭建 Agent。