主题
4.3 模型供应商与工具插件
餐厅有厨师,也需要食材和设备。AI 应用同样如此:模型负责理解与生成,工具负责读取文件、查询信息或转换格式。本节说明这些能力怎样接入 Dify,以及接入后应如何验证。
集成中心的结构与工作原理

1. 厨师与瑞士军刀
模型供应商提供生成、推理或向量计算等能力;工具负责执行具体操作,例如提取文件正文和转换报告格式。可以沿用厨房的分工来理解,但配置时仍应看实际输入、输出和授权要求。
模型供应商 (Model Providers) 体系解析
进入 Dify 左侧导航栏的【集成】->【模型供应商】,即可看到全球主流模型的配置大厅:
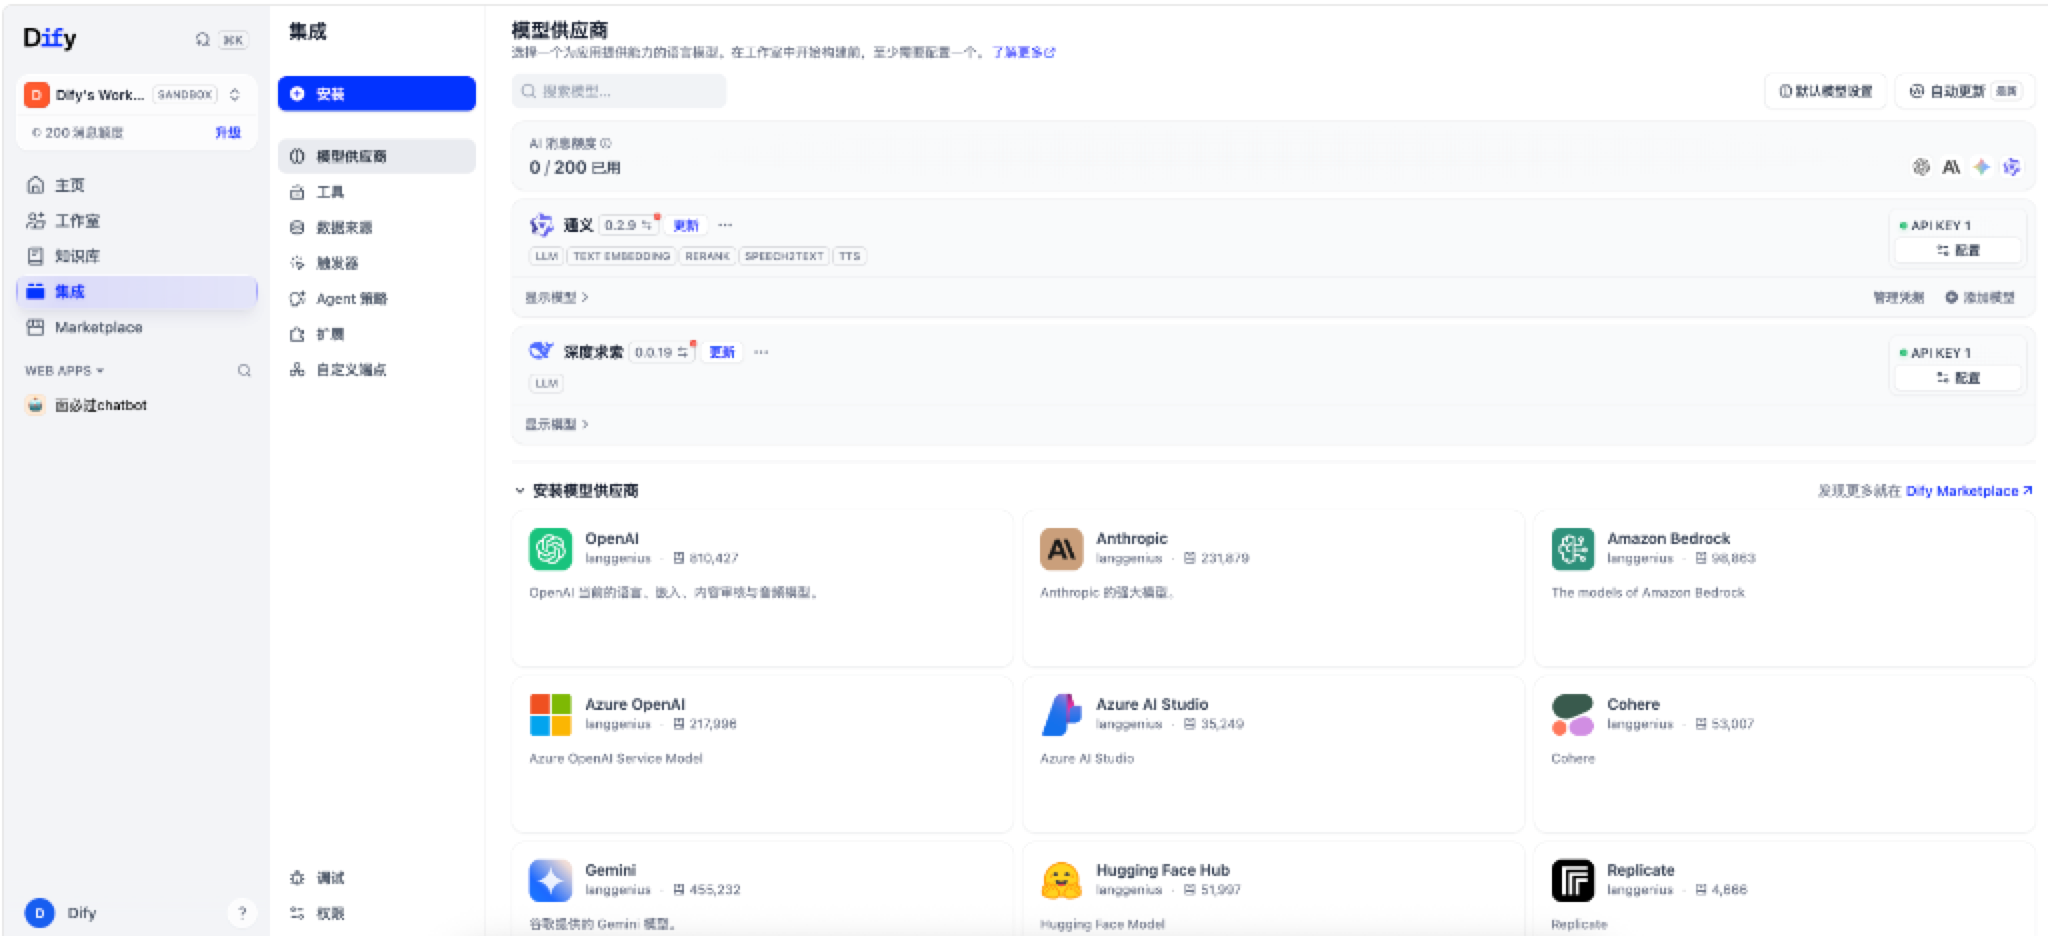
1. 全球主流模型供应商矩阵
Dify 原生支持了全球数十家大模型供应商与开源托管平台:
- 国内模型服务:深度求索 (DeepSeek)、阿里通义千问 (Qwen/DashScope);
- 国际模型服务:OpenAI (GPT系列)、Anthropic (Claude系列)、Google Gemini、Cohere;
- 企业级云与开源推理平台:Amazon Bedrock、Azure OpenAI / Azure AI Studio、Hugging Face Hub、Replicate。
2. 模型的五类能力标签
在模型卡片上(如上图中的通义千问与 DeepSeek),你会看到几个重要的能力胶囊标签。它们代表了模型在 Dify 内部的不同职责分工:
| 能力标签 | 全称与定位 | 对应场景 | 典型应用场景 |
|---|---|---|---|
LLM | 大语言模型 (Large Language Model) | 掌勺大厨(负责理解、推理、生成文本) | 对话生成、文章润色、工作流思考节点 |
TEXT EMBEDDING | 文本嵌入向量化模型 | 智能图书管理员(把文字变成高维数学坐标) | 知识库(RAG)文档分块切片向量化 |
RERANK | 重排序模型 | 决赛裁判(从海选初筛中挑出最精准的段落) | 知识库混合检索后的精准二次排序 |
SPEECH2TEXT | 语音识别转文字 (ASR) | 录音速记员(听懂语音并转成文本) | 语音输入法、电话录音质检分析 |
TTS | 语音合成 (Text to Speech) | 电台播音员(将 AI 生成的文本朗读出来) | 智能外呼、有声读物生成、无障碍播报 |
3. API Key 多密钥池与多账号管理机制
点击供应商卡片右上角的 • API KEY 1,可以展开密钥管理菜单:
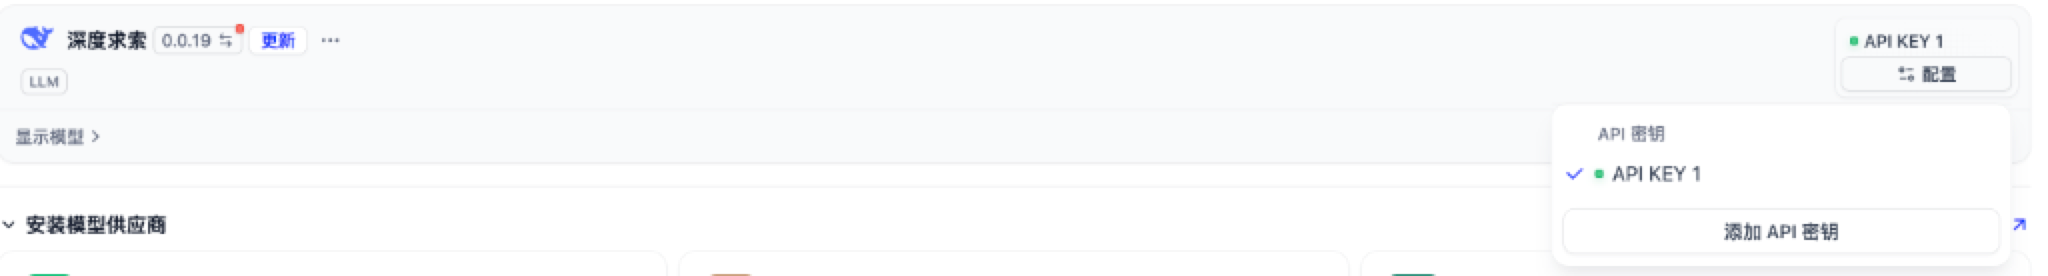
- 多密钥负载均衡与容灾:Dify 支持为一个模型供应商添加多个 API Key(如
API KEY 1、API KEY 2); - 为什么需要多 Key?
- 防止限流 (Rate Limit 熔断):在高并发生产场景下,多 Key 轮询可以有效分摊并发压力;
- 权限与计费隔离:可以按部门或业务线配置专属的 API 密钥与配额消耗监控。
4. 深度求索 (DeepSeek) 模型家族与超大上下文
点击深度求索卡片下方的【显示模型】,可以看到其麾下的 5 大主力模型:
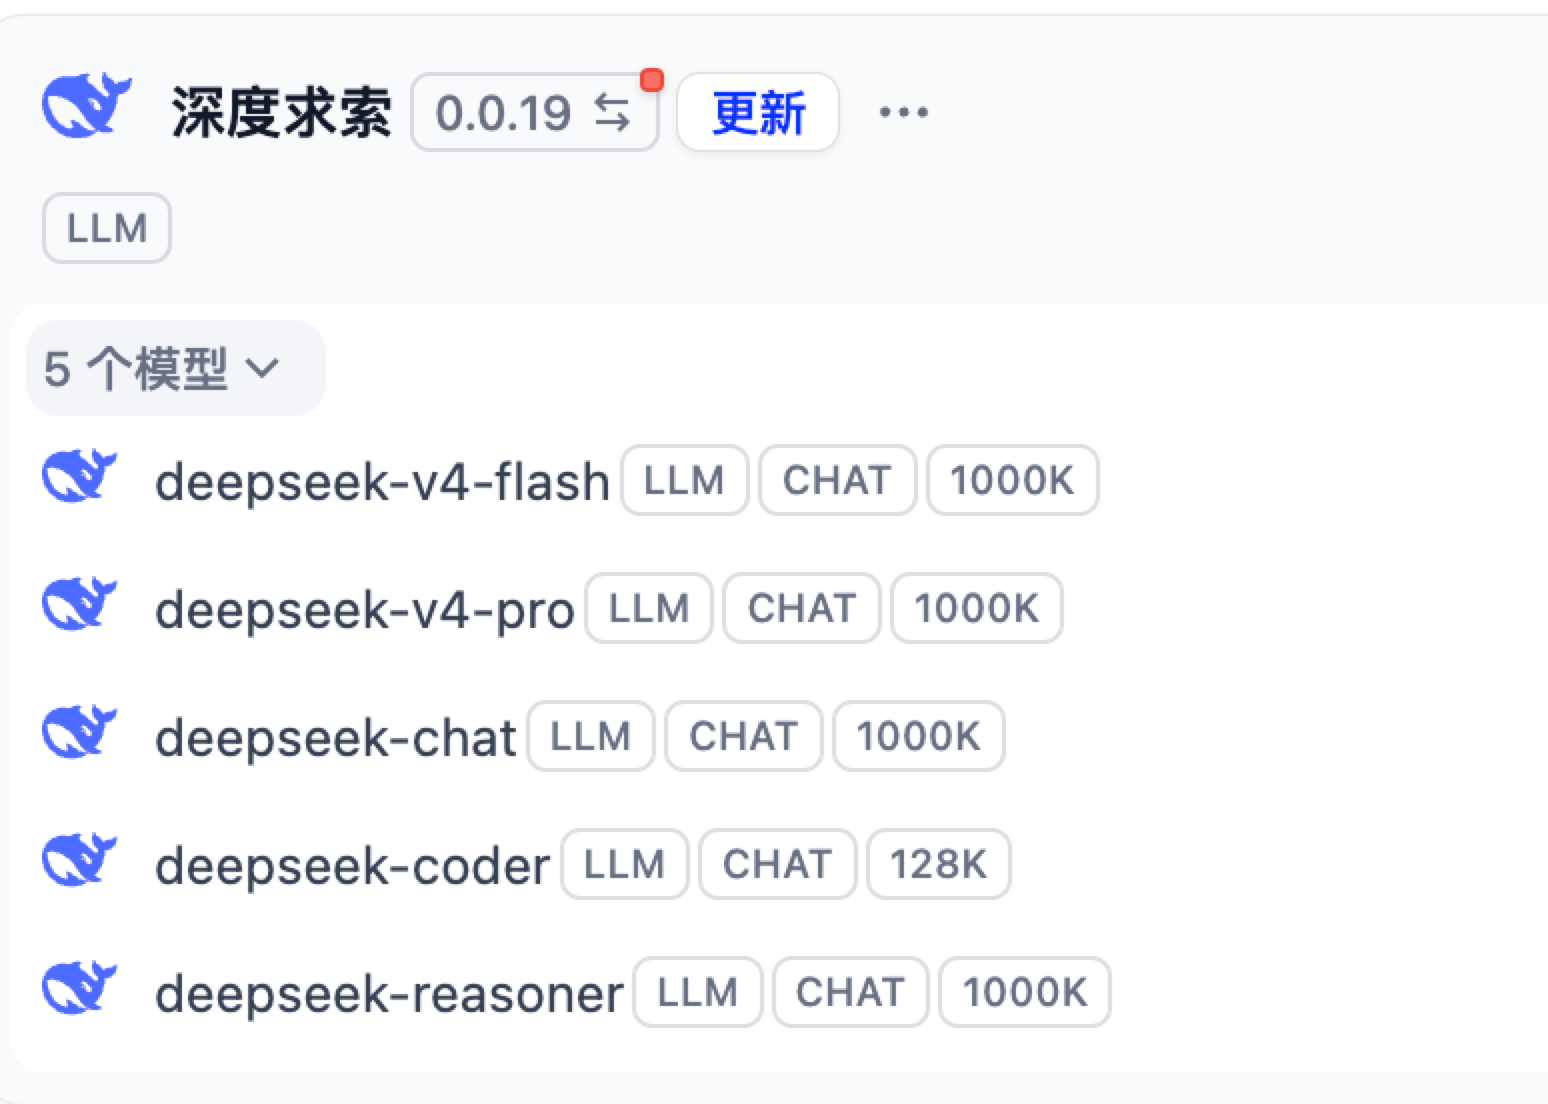
截图保留了案例环境中的模型列表。模型名称、上下文上限和可用参数应以当前供应商文档及插件配置为准,不宜直接照搬截图中的数字。
上下文窗口像一张能摊开资料的桌子:桌子大,能放的材料多,但不代表每份材料都会被正确使用。输入、输出预算和历史消息会共同影响一次请求能处理的内容,汉字与 Token 也没有固定换算比例。用于面试时,应优先保留与当前岗位、当前问题相关的资料。
工具与插件生态 (Tools & Plugins) 解析
点击左侧导航栏的【集成】->【工具】,即可进入工具生态的配置中心:
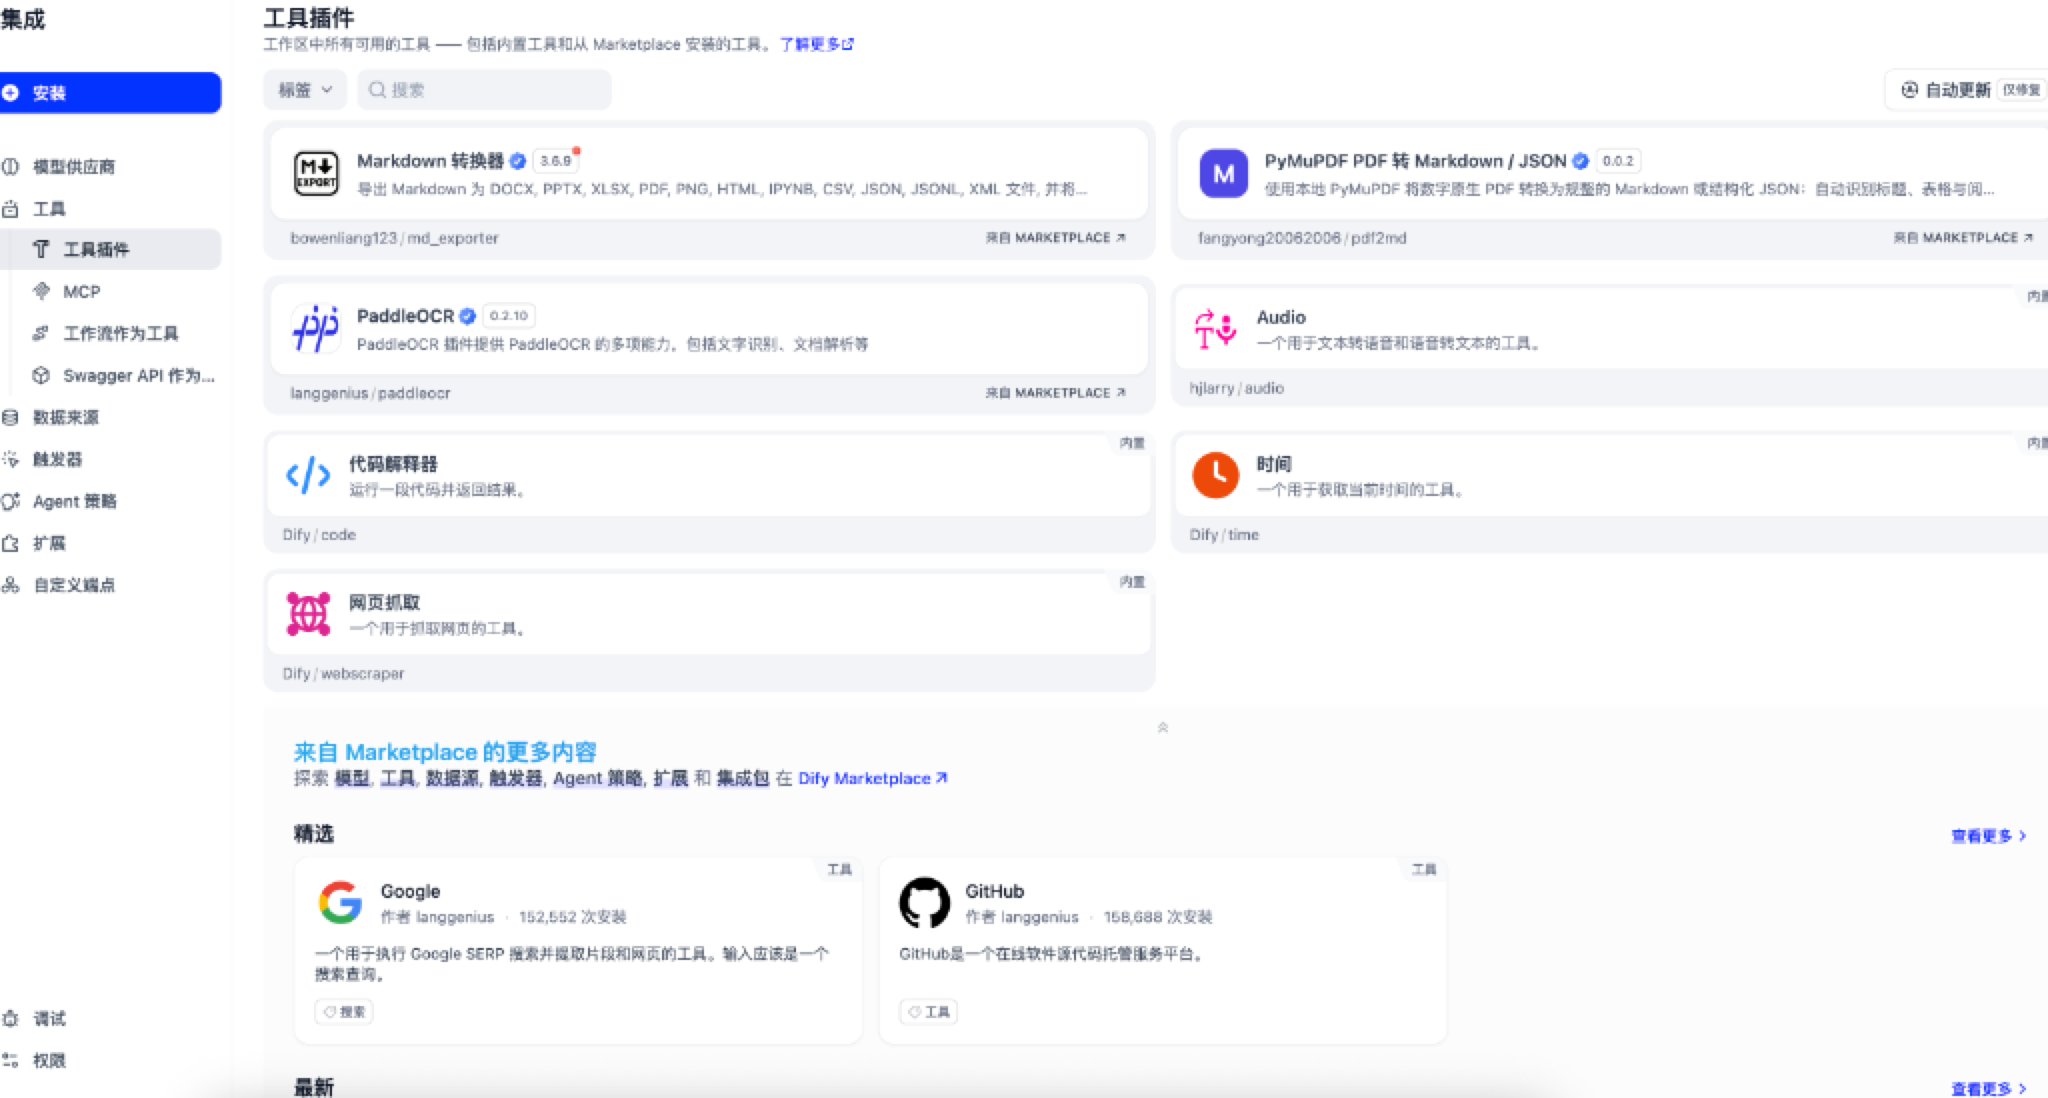
在现代智能体开发中,工具是赋予 AI“手脚”的核心。Dify 将工具体系分为了四大来源:

1. 核心工具插件 (Tool Plugins) 盘点
在工具面板中,我们可以看到丰富的高频实用工具:
Markdown 转换器(来自 Marketplace):一键将 Markdown 格式无损导出为 DOCX、PPTX、XLSX、PDF、PNG、HTML、IPYNB 等十几种格式;PyMuPDF PDF 转 Markdown / JSON(来自 Marketplace):直接使用本地高性能 PyMuPDF 引擎,把数字原生 PDF 解析为排版规整的 Markdown 与结构化表格数据;PaddleOCR(来自 Marketplace):集成百度开源的高精度多语言文字识别与版面文档分析引擎;代码解释器(内置):在安全沙箱内动态执行一段 Python/JS 代码并实时返回运算结果;网页抓取(内置):输入 URL 自动清洗并提取网页主体正文内容;时间(内置):向流程提供当前系统时间,适合处理日期计算、有效期判断等任务。
2. 前沿协议:MCP (Model Context Protocol) 深度支持
- 什么是 MCP?
MCP (Model Context Protocol) 是由 Anthropic 于 2024 年底提出、并在 2025/2026 年迅速成为全行业事实标准的开放大模型通信协议。 - Dify 接入 MCP:需要确认平台支持的传输方式,以及 Dify 运行环境能否访问服务地址。云端 Dify 无法直接把你电脑上的本地进程当作可访问服务。
3. 进阶用法:把工作流发布为工具 (Workflow as Tool)
- 核心概念:你在工作室中精心搭建好的一条复杂工作流(比如“专利查重工作流”),可以一键发布为“工具”;
- 协同效应:在其他的 Chatflow 或多 Agent 决策系统中,大模型可以直接把这条工作流当作一个独立函数来调用,实现系统架构的高内聚与模块化复用。
4. 企业级系统打通:Swagger / OpenAPI 快速导入
- 传统企业内部已经积累了成百上千个微服务 API;
- 在 Dify 中,你只需上传现有的
swagger.json或openapi.yaml接口描述文件,Dify 就会自动解析出所有入参、出参和接口描述,瞬间把沉睡的传统企业 API 升级为 AI Agent 可以自主调用的智能工具。
生产环境最佳组合与选择依据
在真实的 Vibe Coding 与 Agent 落地中,建议采用以下组合策略:
- 思考中枢 (Reasoning Brain):
- 复杂长文本研究、跨文件代码重构、数学计算:选用
deepseek-reasoner或Claude 3.5 Sonnet; - 高频快速对话、日常数据清洗:选用
deepseek-chat、通义千问或GPT-4o-mini,兼顾响应速度与超低成本。
- 复杂长文本研究、跨文件代码重构、数学计算:选用
- 知识检索 (RAG Pipeline):
- Embedding 模型优先选用专精向量模型(如
text-embedding-3-large、bge-large-zh); - 配合
RERANK标签模型(如bge-reranker-large、Cohere Rerank)进行决赛精筛。
- Embedding 模型优先选用专精向量模型(如
- 工具外挂 (Tool Arming):
- 文档解析选用
PyMuPDF+PaddleOCR; - 外部业务联通用
Swagger / OpenAPI快速挂载企业后台。
- 文档解析选用
按任务验证模型和工具
为一个岗位招聘多人时,会分别考察写作、沟通和资料整理能力;选择模型也应该按节点任务测试。本例的意图分类关注选项是否正确,简历优化关注是否保留事实,报告生成关注长文本是否完整。这几项能力不能只靠一次闲聊判断。
可以准备一组固定材料:一份较短简历、一份缺少时间信息的简历,以及一句含糊的请求。每次更换模型,都用同样材料比较结果,并记录耗时、失败情况和用量。先找出不达标的节点,再决定是否只替换该节点的模型。
工具则需要单独验证输入与返回值。例如导出工具收到的是 Markdown 还是 HTML,返回的是文件对象还是下载地址,地址能保存多久。这些都应根据实际插件说明确认,不能从插件名称推断。
遇到故障时按层排查:授权失败先看凭据,请求超时先看网络与服务状态,字段错误再看参数约定。反复修改提示词无法修复无效密钥,也不能改变工具要求的参数类型。
把模型问题和工具问题分开定位
一个节点报错后立刻更换模型,往往会把真正原因带到新的配置里。更稳妥的办法是把调用链拆成两个最小测试:先让模型只返回固定格式的短结果,再给工具节点一份人工准备的合格输入。这样能判断失败发生在生成、参数转换,还是外部工具本身。
| 现象 | 先做的独立检查 | 需要记录的信息 |
|---|---|---|
| 模型节点没有输出 | 用最短提示词单独调用 | 模型名、错误码、耗时、输入长度 |
| 工具提示字段缺失 | 手工构造一份完整参数 | 字段名、类型、必填规则 |
| 偶发超时或限流 | 用同一输入重复少量测试 | 发生时间、重试次数、服务返回信息 |
| 更换插件后格式变化 | 对比新旧返回样例 | 插件版本、输出字段、下游引用 |
正式流程还应固定已经验证过的模型和插件版本,并在升级前保存一组回归输入。升级带来字段或行为变化时,先在副本中验证,再更新正式流程及其说明。
模型与插件入口可查阅 Dify 官方插件市场;本例中的具体模型名称仅作为配置示例,实际可用项以当前工作区为准。
参考资料
- Dify 模型供应商配置官方文档:https://docs.dify.ai/v/zh-hans/guides/model-configuration
- Dify 插件与工具生态官方指南:https://docs.dify.ai/v/zh-hans/guides/tools
- Model Context Protocol (MCP) 官方标准:https://modelcontextprotocol.io
- Dify 官方 Marketplace 插件广场:https://marketplace.dify.ai