主题
4.4 认识「面必过」求职助手
「面必过」包含模拟面试和简历优化两条流程。我们借这个案例观察:同一段用户输入如何进入合适的分支,多轮交流的材料保存在哪里,最后怎样整理成报告。名称只是案例名称,不代表对求职结果的承诺。
项目定位与业务痛点:传统单次 AI 为什么搞不定模拟面试?
1. 官方权威档案与案例概览
- 项目名称:面必过 chatbot
- 应用形态:
advanced-chat(高级对话流 / Chatflow) - 核心业务场景:
- 沉浸式模拟面试:支持多轮真实深度技术面试、问答记忆滚雪球记录、以及面试结束后的多专家(表现评估 + 改进方案 + 技术复盘)HTML 报告导出;
- 多专家圆桌式简历优化:基于目标职位(JD),由 JD 匹配师、HR 审核师、内容优化师三方评审,输出符合 STAR 原则的精修简历并生成排版 HTML。
- 源码参考:本项目目录下的
面必过chatbot .yml(Dify 标准 DSL 配置文件)。
2. 传统单次大模型问答的“三个常见问题”
如果我们直接在 ChatGPT 或单次 LLM 对话框里说“请帮我模拟面试”,通常会迅速陷入以下尴尬困境:
| 常见问题 | 产生原因 | 表现 |
|---|---|---|
| 1. 金鱼记忆与节奏失控 | 缺乏专门的问答历史提取与变量追加机制 | 聊到第 3 轮,AI 就忘记了第 1 轮问了什么、候选人怎么回答的,甚至反复问相同的问题。 |
| 2. 意图乱窜与身份漂移 | 缺乏多轮会话的“状态锁(State Lock)”机制 | 当候选人回答“这个技术我没用过”时,AI 误以为用户在日常闲聊,直接跳出面试官角色开始科普技术。 |
| 3. 产出单薄无结构 | 缺乏多专家协同评审与后处理流水线 | 面试结束后只能给出几句不痛不痒的套话评语,无法输出可量化打分、有实操改进方案的专业复盘报告。 |
3. 游乐园入场手环与多人分工评审
针对上述问题,「面必过」工作流采用了两个主要设计:

设计思路一:状态机与状态锁(State Machine & State Lock) 就像去迪士尼乐园,你在门口检票后会戴上一个**“专属手环”**。在园内游玩期间,你无需每次去新项目都在大门口重新安检排队。系统通过
current_mode变量锁定你的状态:只要手环在,你的每一句话都被认定为“面试回答”;直到面试结束剪断手环,状态才被重置。设计思路二:多专家圆桌评审(Multi-Agent Collaboration) 无论是面试复盘还是简历精修,不再靠单一模型草草了事,而是引入了类似三甲医院专家联合评审的机制:主考官打分、技术专家挑刺、HR 评估稳定性、文字润色师重塑表达,最后由圆桌主持汇总交付。
「面必过」工作流整体结构
下图是「面必过」在 Dify 平台画布中的完整编排全貌(去img目录打开看吧):
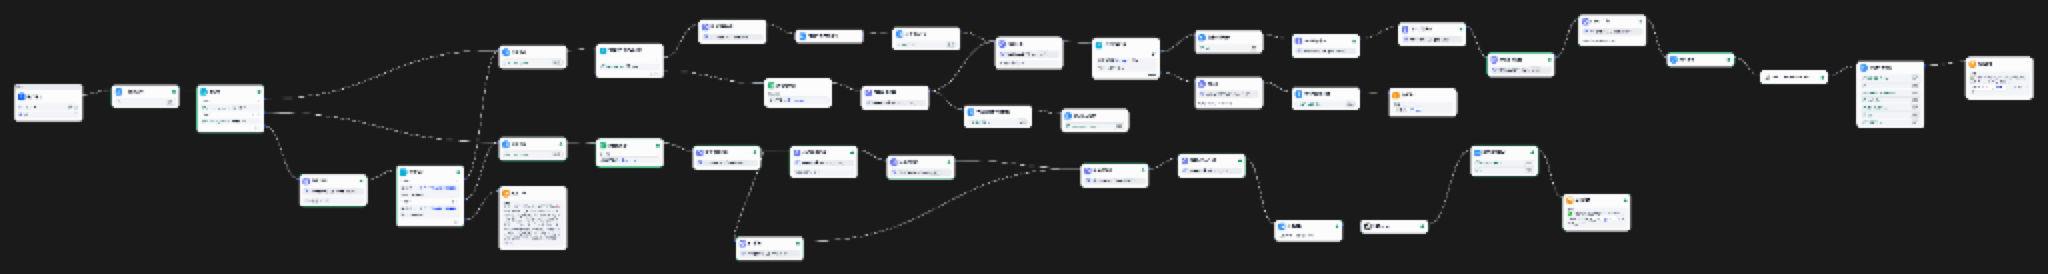
全局架构流向图

设计要点:7 大会话变量(Conversation Variables)说明
在 Dify 的 Chatflow 中,会话变量(Conversation Variables) 是整个应用维持长周期记忆、状态切换与数据传递的“全局数据库”。
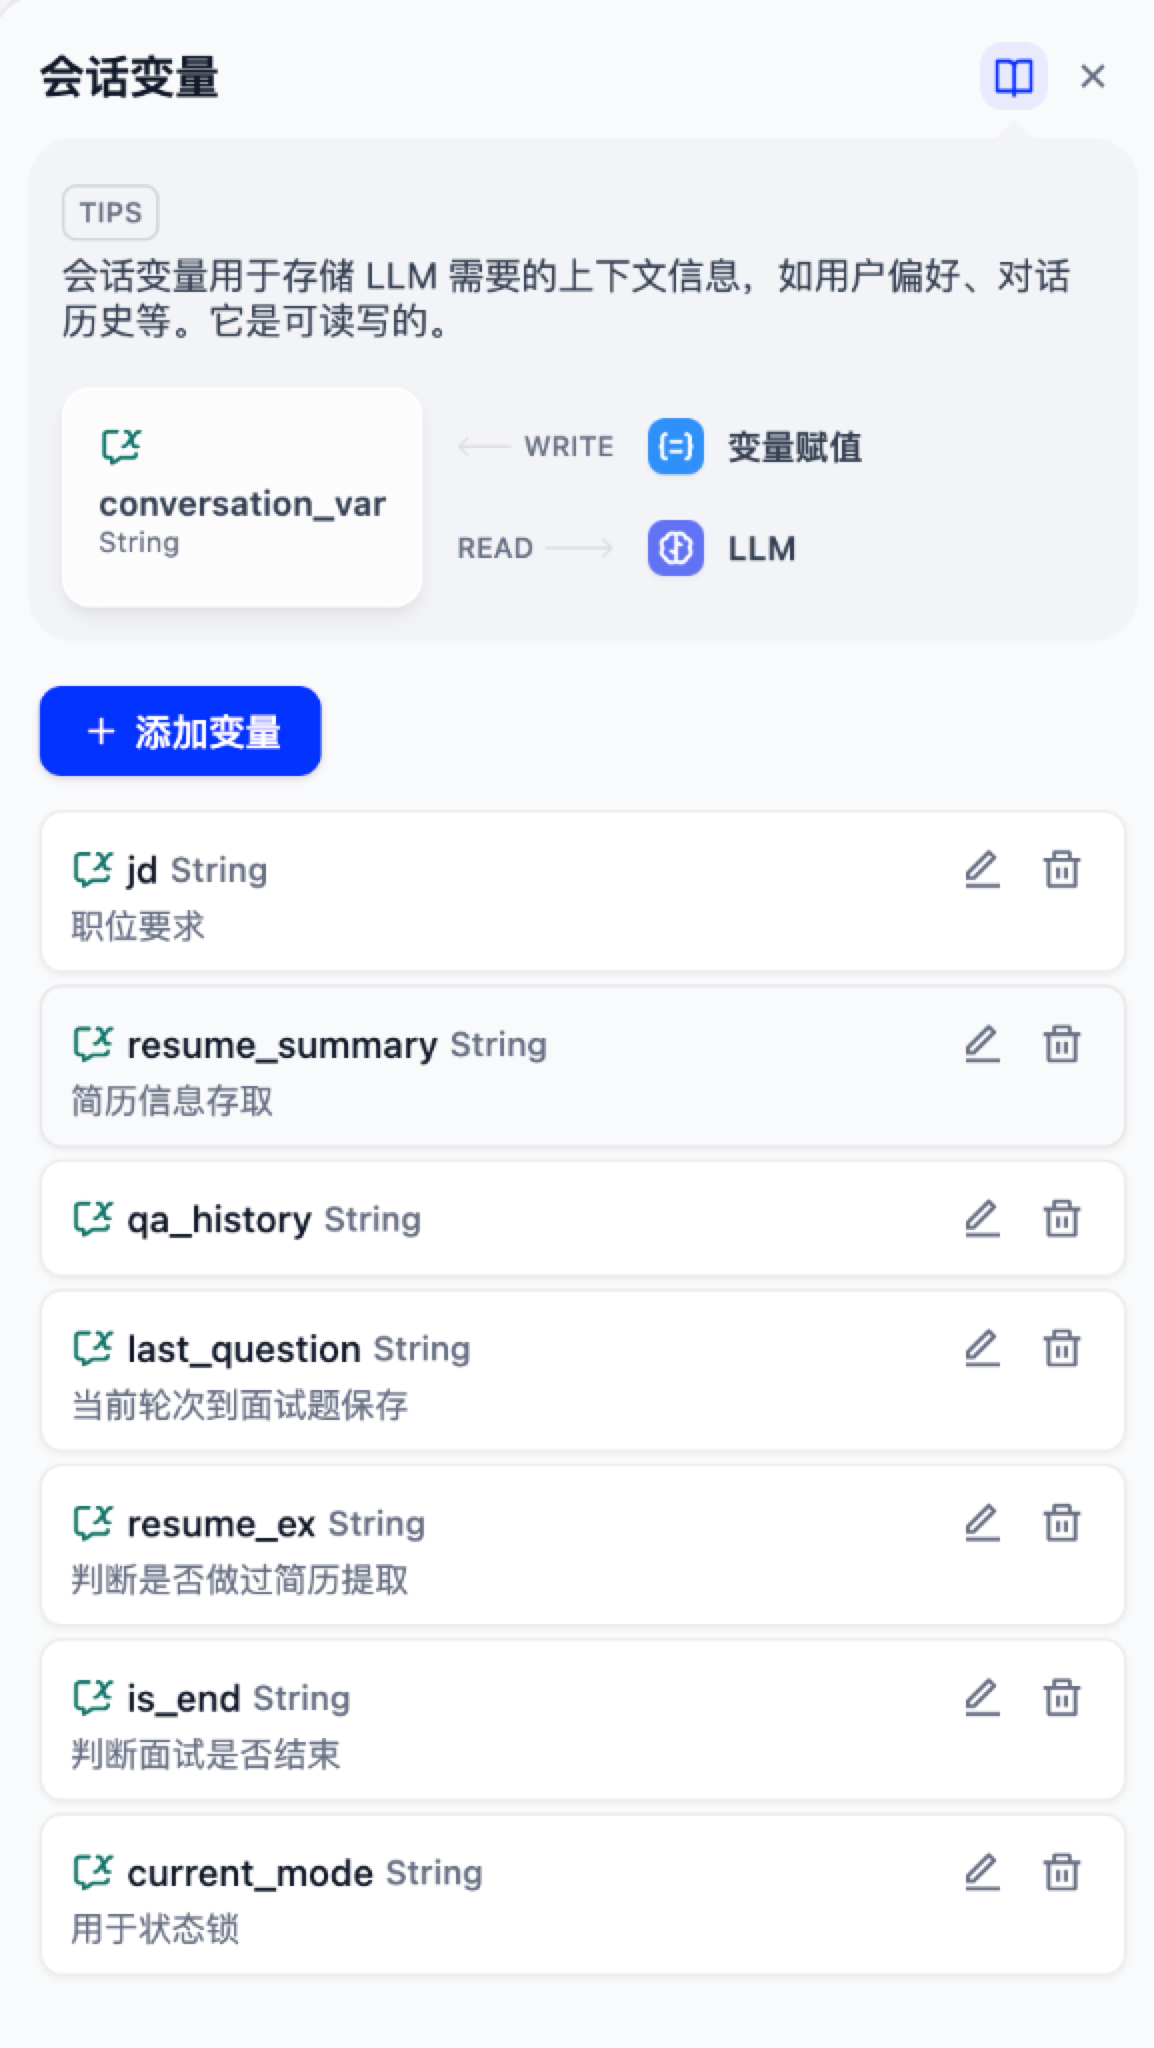
在「面必过」工作流中,一共精心设计了 7 个核心全局变量:
| 变量名 (Name) | 数据类型 (Type) | 核心职责 | 写入时机 (Write) | 读取时机 (Read) | 对应场景 |
|---|---|---|---|---|---|
current_mode | String | 状态锁:标记当前处于面试、简历优化还是自由状态 | 意图分流后写入 interview 或 resume;结束时赋空值 | 每次用户发送消息时,由「状态锁」节点首先读取 | 游乐园手环(戴上则专人专带,取下恢复自由) |
jd | String | 存储用户提供的目标岗位 JD 要求 | 会话入口节点提取并持久化 | 面试出题、JD 匹配分析师对比时读取 | 招聘方的考纲 |
resume_summary | String | 存储从用户上传附件中提取的结构化简历文本 | 首次上传简历解析后一次性写入 | 面试引擎出题、简历优化各专家分析时读取 | 候选人档案袋 |
resume_ex | String | 提取标志位:标记简历是否已经完成过解析提取 | 首次提取完成后置为 '1' | 每一轮面试前判断,防止重复耗费 Token 解析 | 体检盖章“已检查” |
qa_history | String | 多轮问答记忆库:按轮次滚雪球记录所有问答对 | 每一轮用户回答后,经 Python 格式化拼接追加 | 面试引擎判断回答质量、技术复盘专家终审时读取 | 面试全程录音笔速记 |
last_question | String | 暂存当前轮次面试官提出的上一道问题 | 每次生成新试题后立即覆盖更新 | 用户回答时,与用户的新答案拼装成问答对 | 黑板上当前写的那道题 |
is_end | String | 完结信号:标记面试是否达到终止轮次或候选人主动交卷 | 面试引擎判定达到结束条件时置为 'true' | 结束变量判断节点读取,决定是继续出题还是开启复盘 | 交卷铃声 |
依赖生态解密:DeepSeek 插件到底是什么?它与 LLM 节点是什么关系?
很多初学者在查看 DSL 的 dependencies 依赖配置时,会产生一个经典的疑问:
“既然工作流里直接拖出来的都是 LLM 节点,那依赖里的 DeepSeek 插件到底是什么?不就是一个 LLM 节点吗?”
1. 从“一体化硬编码”到“模块化插件架构”
在 Dify 的早期版本中,大模型供应商(OpenAI、DeepSeek 等)的代码是直接写死在 Dify 核心源码里的。随着全球大模型爆炸式涌现,Dify 在 v0.7+ / v1.0+ 中全面升级为 Marketplace 插件化生态架构:

- LLM 节点(方向盘与控制台):工作流画布中的一个通用功能积木。你可以在这个节点里填 Prompt、设 Temperature、绑输入输出变量。
- DeepSeek 插件(发动机引擎驱动):Dify 官方插件市场中的供应商驱动包(Model Plugin)。它向 Dify 平台注册了
deepseek-chat(V3 快速大模型)与deepseek-reasoner(R1 深度推理大模型)的接入协议。 - Markdown 转换器插件(
bowenliang123/md_exporter):一个工具插件(Tool Plugin),负责将大模型生成的 Markdown 文本在沙箱内转换为现代化排版、支持一键打印与样式渲染的高保真 HTML 网页文件。
**一句话总结**:依赖项中的 `langgenius/deepseek` 是“驱动程序”,有了它,你的通用 LLM 节点才能在下拉列表里认出并调用 DeepSeek 模型。
导入 DSL 与准备运行环境
要在你自己的 Dify 平台中复现并体验「面必过」工作流,只需三步:
- 安装依赖插件:
- 进入 Dify 导航栏的 「Marketplace」;
- 搜索并安装
Markdown 转换器(作者:bowenliang123); - 确保模型供应商中已配置好
DeepSeek的 API Key。
- 导入 DSL 文件:
- 进入 「工作室 (Studio)」 -> 点击右上角 「导入 DSL 文件」;
- 选择本项目目录下的
面必过chatbot .yml并点击创建。
- 环境检查:
- 导入后,点击左侧 「会话变量」,确认 7 个变量(
current_mode、jd等)已全部正确就绪。
- 导入后,点击左侧 「会话变量」,确认 7 个变量(
用一条用户路径检查整体设计
先想象一位用户的完整经历:上传简历、补充岗位要求、开始面试、回答几个问题、提前结束并查看反馈。沿着这条路径逐步查看状态变量,可以发现单看画布不容易看出的遗漏。
| 用户动作 | 流程应处理的事 | 验证重点 |
|---|---|---|
| 第一次上传简历 | 提取资料,确认任务 | 不把文件名当成正文 |
| 补充岗位要求 | 保存本次目标岗位 | 后续分析使用同一份要求 |
| 回答面试问题 | 继续当前面试并记录回答 | 不重复进行无关的意图分流 |
| 要求结束 | 整理已完成的问答 | 不为未回答的问题编造评价 |
| 开始下一次练习 | 重置上一轮任务状态 | 不混入旧岗位和旧问答 |
这里的“状态锁”只表示会话当前走哪条业务路径,类似办理业务时拿到的分类号码。它不是数据库锁,也不提供并发互斥或访问权限控制。理解这个边界,才能避免把一个路由变量当成通用安全机制。
阅读 DSL 时,可以先找入口、两个业务分支和最终回复,再追踪这些位置读写的变量。先弄清一条路径,再展开专家节点,比按画布位置逐个阅读更有条理。
先画用户路径,再阅读复杂画布
这个案例实际上包含“模拟面试”和“简历优化”两条业务路径。阅读前可以分别写出入口、所需材料、关键状态和结束条件,再回到画布寻找对应节点。这样能避免被连线数量影响判断,也更容易发现两个流程意外共用了变量。
对每条路径至少回答四个问题:用户没有上传简历时怎样继续;岗位要求缺失时是否允许分析;流程结束后哪些状态要清空;用户中途改变任务时从哪里切换。画布中的每个主要分支都应能对应到一个明确的用户动作或异常情况。
完成阅读后,用两次连续会话验证边界:第一次进入面试并提前结束,第二次直接选择简历优化。若第二次仍读到上一轮的题目、岗位或模式,说明状态清理还不完整。这个测试比只跑通两条独立路径更能反映真实使用情况。
本节回顾
先沿一条用户路径阅读案例,再追踪状态变量的读写。这样既能理解整体流程,也能发现开始、结束和重新运行时的遗漏。
继续阅读:4.5 会话状态、意图识别与分支路由。