主题
4.1 Dify 核心概念与平台功能
Dify 把模型调用、资料检索和工具执行放到同一张画布上。就像厨房按工序安排备料、烹饪和出餐,我们也可以把一个 AI 任务拆成几个步骤,再约定每一步接收什么、交出什么。本节先认识这些部件,为后面的求职助手案例做准备。
Dify 适合解决哪些问题?
1. 官方权威档案
- 官方网站:https://dify.ai
- 官方开源代码仓:https://github.com/langgenius/dify
- 官方开发者文档:https://docs.dify.ai
- 定位:开源的 LLM 应用开发与 LLMOps(大模型运维)协同平台。

2. 现代智能中央厨房
如果把开发一个 AI 应用比作**“开一家餐厅”**:
- 传统纯手写代码:你得自己砌灶台、自己买煤气罐、手写菜单、自己下地种菜、洗菜切菜、手算账单,需要逐项维护;
- Dify 平台:直接为你提供了一间现代化智能中央厨房:
- 大厨 = 大语言模型(LLM,负责理解意图并掌勺炒菜);
- 私房秘籍与原料仓 = 知识库(Knowledge / RAG,提供独家菜谱与精准资料);
- 自动洗菜切菜流水线 = 工作流(Workflow,按照规定步骤一步步处理食材);
- 跑腿外卖员 = 外部工具与插件(Tools / Plugins,帮大厨上网查最新食材价格、调用配送 API);
- 点餐大堂与外卖窗口 = Web App 与开放 API 接口(顾客进门直接点单,或者第三方平台一键对接)。
Dify 平台主界面全貌与功能拆解
下面是 Dify 登录后的核心主页全貌:
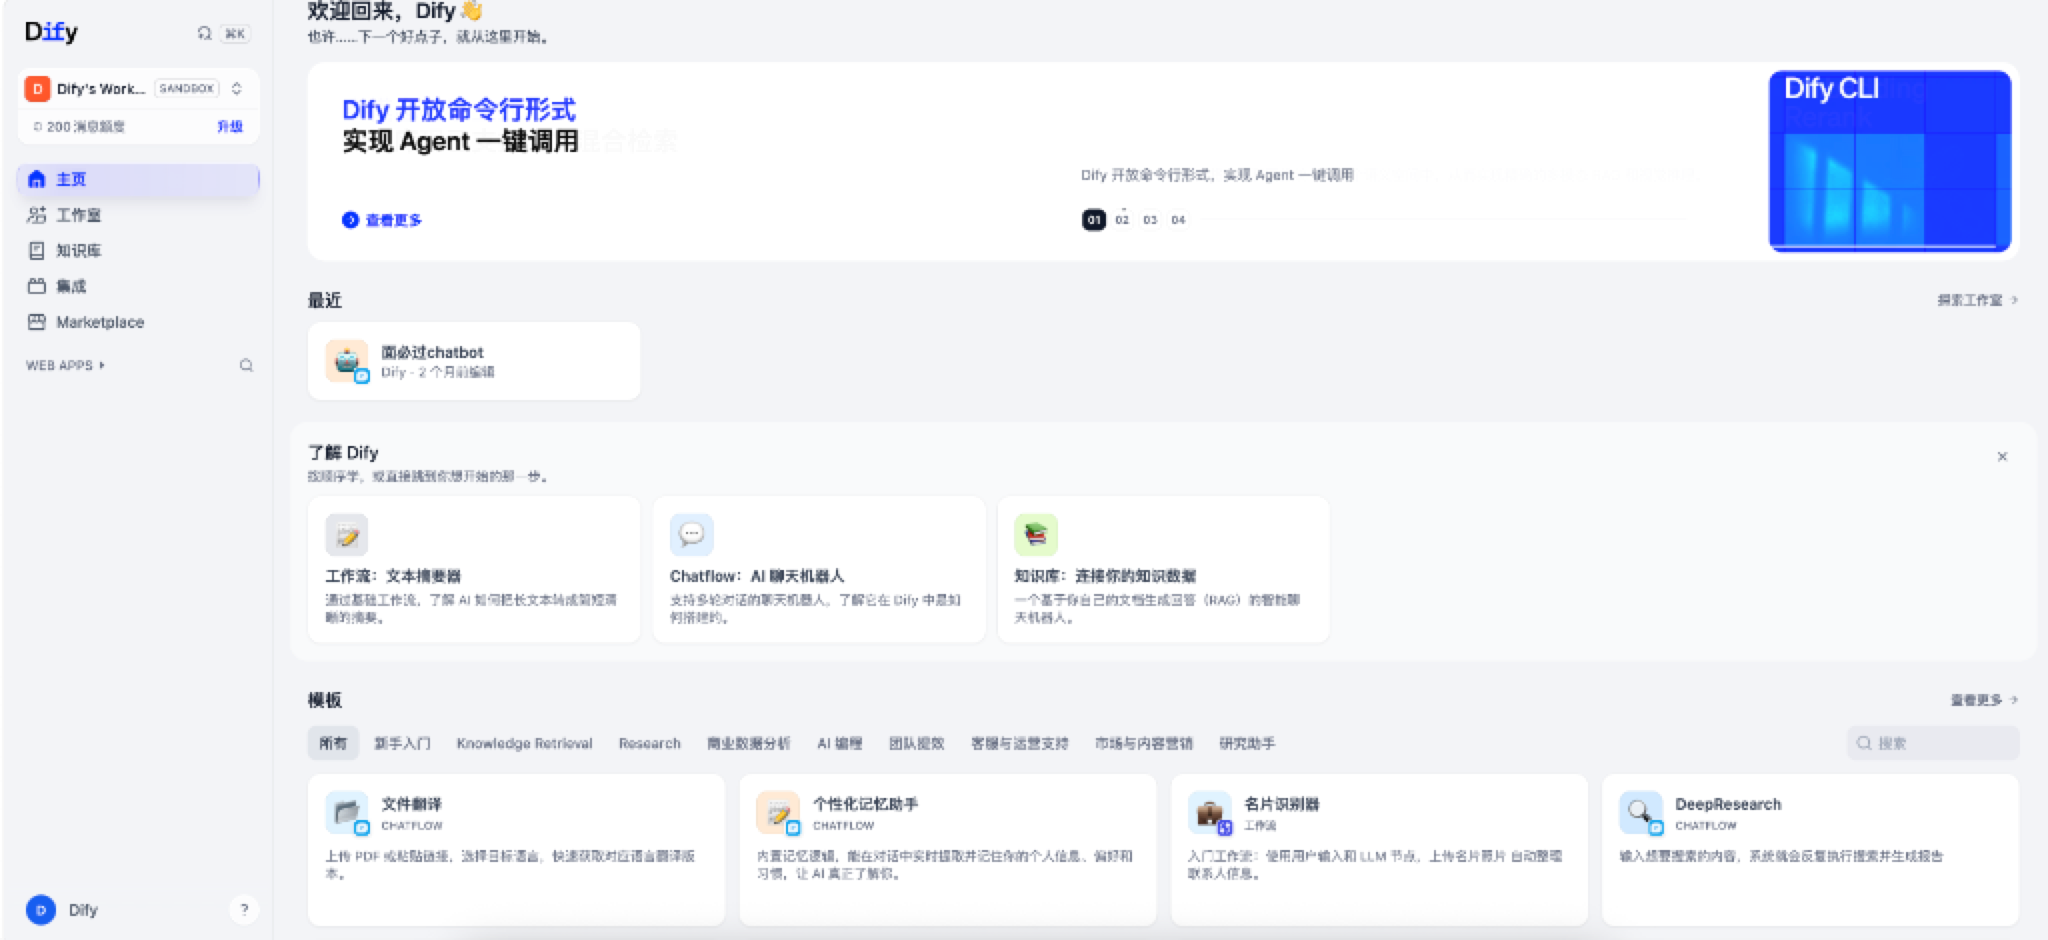
结合上方主页,我们逐一拆解 Dify 的核心功能分区:
1. 左侧全局导航栏 (Navigation Bar)
- 主页 (Home):总览推荐、快捷入口、最新功能动态与热门模板推荐;
- 工作室 (Studio):核心工位。在这里创建、编排、调试你的 Chatflow(对话流)、Workflow(工作流)、Agent(智能体)以及基础文本应用;
- 知识库 (Knowledge):企业私有数据中枢。支持上传 PDF、DOCX、Markdown、TXT、网页 URL,平台自动完成文档清洗、切片分块(Chunking)、向量化嵌入(Embedding)与多路混合检索;
- 集成 (Tools & Integrations):连接外部世界的万能插座。内置高德天气、Google 搜索、维基百科、代码执行沙箱,并支持自定义 OpenAPI 插件与 MCP 协议;
- Marketplace (插件市场与模型广场):官方与开源社区共享的现成应用模板、扩展插件与实用工具,一键安装即用;
- Web Apps 独立展示区:所有对外发布的独立 Web 应用快捷入口,无需前端开发即可直接分享给终端用户使用。
2. 顶部能力升级:Dify CLI 命令行与 Agent 调度
- Dify 现已全面支持 Dify CLI 命令行交互工具。
- 核心价值:不仅能在浏览器画布中拖拽,还能通过终端命令行(CLI)直接调用已发布的工作流与 Agent,方便融入自动化脚本、CI/CD 流水线以及本地开发终端。
3. 主页推荐:三大核心应用形态
在主页的“了解 Dify”专区,官方推荐了三大基石形态:
| 应用形态 | 核心特点 | 对应场景 | 典型应用场景 |
|---|---|---|---|
| 工作流 (Workflow) | 单向任务流水线,无状态,输入立即触发执行并输出 | 工业自动化流水线(原料进去,成品打包出来) | 长文本深度摘要、批量发票/名片信息提取、跨系统数据清洗 |
| Chatflow (对话机器人) | 带记忆状态机,支持多轮上下文交互与多分支跳转 | 懂你心意的一对一专属客服顾问 | 智能面试助手、个性化学习私教、智能在线客服 |
| 知识库 (Knowledge / RAG) | 挂载专属私有文档,提供向量检索与精准溯源参考 | 开卷考试时的专业参考书库 | 企业内网问答、法律法规检索助手、技术文档库 |
4. 丰富模板生态 (Templates Hub)
Dify 主页内置了海量开箱即用的行业模板:
- 文件翻译 (Chatflow):上传多语言 PDF 或粘贴链接,自动保持专业术语一致性翻译;
- 个性化记忆助手 (Chatflow):在多轮对话中实时提取并长效存储用户的个人喜好、偏好习惯;
- 名片识别群 (Workflow):利用视觉多模态与 OCR 提取名片字段,自动整理归档;
- DeepResearch (Chatflow):输入研究主题,系统全自动发起多轮迭代式网络深度搜索并输出完整长篇研报。
Dify 底层核心概念与节点体系解析
要在 Dify 中编排较复杂的流程,需要先分清以下六个概念:

1. 节点体系 (Node Architecture)
工作流画布中的每一个积木块都是一个独立的功能节点:
- 开始节点 (Start Node):定义工作流的输入变量(例如:用户上传的文章、选定的语言、目标格式);
- LLM 节点:模型调用。自由切换 GPT-4o、Claude 3.5 Sonnet、DeepSeek-V3 等大模型,配置 System Prompt 与温度参数(Temperature);
- 知识检索节点 (Knowledge Retrieval):连接知识库,根据输入关键词或向量在文档中寻找最相关的参考切片,注入给下个节点;
- 代码节点 (Code Node):在独立沙箱环境中运行 Python 3 或 JavaScript 代码,处理较复杂的字符串拼接、JSON 提取和正则匹配;
- 条件分支节点 (IF/ELSE Branch):根据前置节点的输出结果(如情绪是否为负面、字数是否超标)走不同的执行流;
- 工具节点 (Tool Node):调用天气查询、网页抓取、算术运算、DALL-E 画图等外部功能插件;
- HTTP 请求节点 (HTTP Request):向任意外部 RESTful API 发起 GET/POST 请求,对接自建后端系统或第三方 Webhook;
- 模板转换节点 (Template Transform):使用 Jinja2 语法将多个分散的变量组装成一段结构化长文本或 Markdown;
- 变量聚合器节点 (Variable Aggregator):统一互斥分支的同类型输出,供后续节点引用;并行分支的结果应另行合并;
- 结束/直接回复节点 (End / Answer Node):将最终处理完成的结果返回给用户或下游调用方。
2. 变量引用与上下文机制 (Variable Reference)
在 Dify 中,所有节点之间的数据流转通过统一的变量引用语法实现:
- 格式:
{{#node_id.output_key#}} - 例如:
{{#start.user_query#}}表示获取开始节点中用户输入的查询内容;{{#knowledge_retrieval.result#}}表示获取知识库召回的参考文本; - 系统内置变量:
{{#sys.query#}}:用户当前轮次输入的原始问题;{{#sys.conversation_id#}}:当前会话的唯一标识 ID;{{#sys.user_id#}}:终端用户的唯一识别标识;{{#sys.files#}}:用户随消息上传的多模态附件列表(图片、音频、文档)。
3. LLMOps 与全生命周期运营支持
Dify 不仅仅是一个画布编辑器,更是一个包含调试、发布和日志功能的应用开发平台:
- 实时调试与单步运行 (Debug & Run):在画布上点击任意节点即可单独运行测试,观察输入与输出数据流,排错定位问题;
- 版本控制与 DSL 导出:支持一键将整个画布编排导出为
.yml格式的 DSL 描述文件,版本变动清晰可查; - 日志与全流程追踪 (Logs & Tracing):记录真实用户的每一条请求、Token 消耗、延迟耗时、各节点执行状态;
- 数据标注与持续迭代 (Annotation):对线上真实回答进行人工打分与校准纠偏,形成高质量微调或 Few-Shot 数据集;
- API 密钥与访问控制:一键生成 API Key,由自己的后端保管密钥并向 Dify 发起请求,前端调用自己的后端。
先看数据怎么走,再看节点怎么连
假设用户交来一份简历,希望得到三条修改建议。可以先把这件事写成一张交接单:文件解析节点交出简历文本,模型节点交出建议,回复节点负责展示。某个节点完成了自己的工作,并不代表下一步就能接着处理;还要检查输出的类型和字段。
| 交接位置 | 应确认的内容 | 容易忽略的问题 |
|---|---|---|
| 上传文件 → 文档提取 | 是否得到可读文本 | 扫描件可能只有图片,提取结果为空 |
| 文档提取 → 模型 | 文本长度、岗位要求、任务说明 | 文件存在,但模型实际收到的是文件信息而非正文 |
| 模型 → 后续节点 | 返回文本还是对象 | 看起来像 JSON 的字符串,不等于可直接取字段的对象 |
| 最终结果 → 用户 | 正文、链接或附件是否可访问 | 节点有输出,但回复节点没有引用它 |
节点输出通常用于本次运行;需要下一轮继续使用的资料,应明确保存到会话变量。模型的对话记忆又是另一项配置,不能因为画布里有聊天窗口,就认定所有节点都能看到全部历史。
还有一个容易混淆的地方:变量聚合器用于统一互斥分支的输出,并不负责把同时执行的多个专家意见拼在一起。并行结果需要显式传给代码或模板节点整理。参见 Dify 变量聚合器文档。
用变量清单检查节点交接
画布稍微变复杂后,最容易出错的往往不是模型回答,而是上下游对同一个变量的理解不同。可以在搭建前先列一张变量清单,把名称、类型、产生节点、使用节点和空值处理写清楚。比如 resume_text 应当是文档提取后的正文字符串;如果提取失败,它应进入补充材料的分支,而不是继续传给模型。
| 变量 | 保存范围 | 产生位置 | 使用位置 | 为空时怎样处理 |
|---|---|---|---|---|
resume_text | 本次运行或会话 | 文档提取节点 | 简历分析、面试提问 | 提示重新上传或改用文本输入 |
current_mode | 会话 | 意图分流节点 | 后续路由 | 返回任务选择页 |
review_result | 本次运行 | 专家评审节点 | 报告整理节点 | 标记该项评审失败,不伪造结果 |
还要区分三种看起来相似的“记住”:节点输出只供当前链路继续使用,会话变量用于多轮交互,模型记忆则由 LLM 节点的上下文配置决定。排查时先确认数据究竟应保存在哪里,再检查变量引用;否则很容易通过不断加长提示词掩盖状态设计的问题。
本节回顾
理解 Dify 时,先分清节点职责、数据类型和状态保存位置。下一步可以创建一个最小应用,观察一份输入怎样变成输出。
继续阅读:4.2 创建应用:空白画布、模板与 DSL 导入。