主题
4.5 会话状态、意图识别与分支路由
面试进行到一半,候选人回答“这个我不太熟”,系统应该继续追问,而不是重新猜测用户想做什么。本节从这个问题出发,介绍会话状态、意图分类和条件分支怎样配合。
中央调度室全貌:四道关卡设计
用户在前端界面发来一句话(例如:“我想面试 Java 高级开发,这是我的简历”),在进入具体的业务流水线之前,必须经历中央调度室的 四道精密关卡:

关卡一与关卡二:输入预处理与状态锁(If-Else)分流
1. 输入预处理与 JD 持久化
- 用户输入节点:接收用户的原始消息(
sys.query)与可能上传的附件文件(PDF/Word/图片); jd信息提取(Assigner 赋值节点):将输入中包含的岗位描述存入全局会话变量conversation.jd,方便后续出题引擎与匹配专家随时读取。
2. 状态锁(If-Else)节点配置
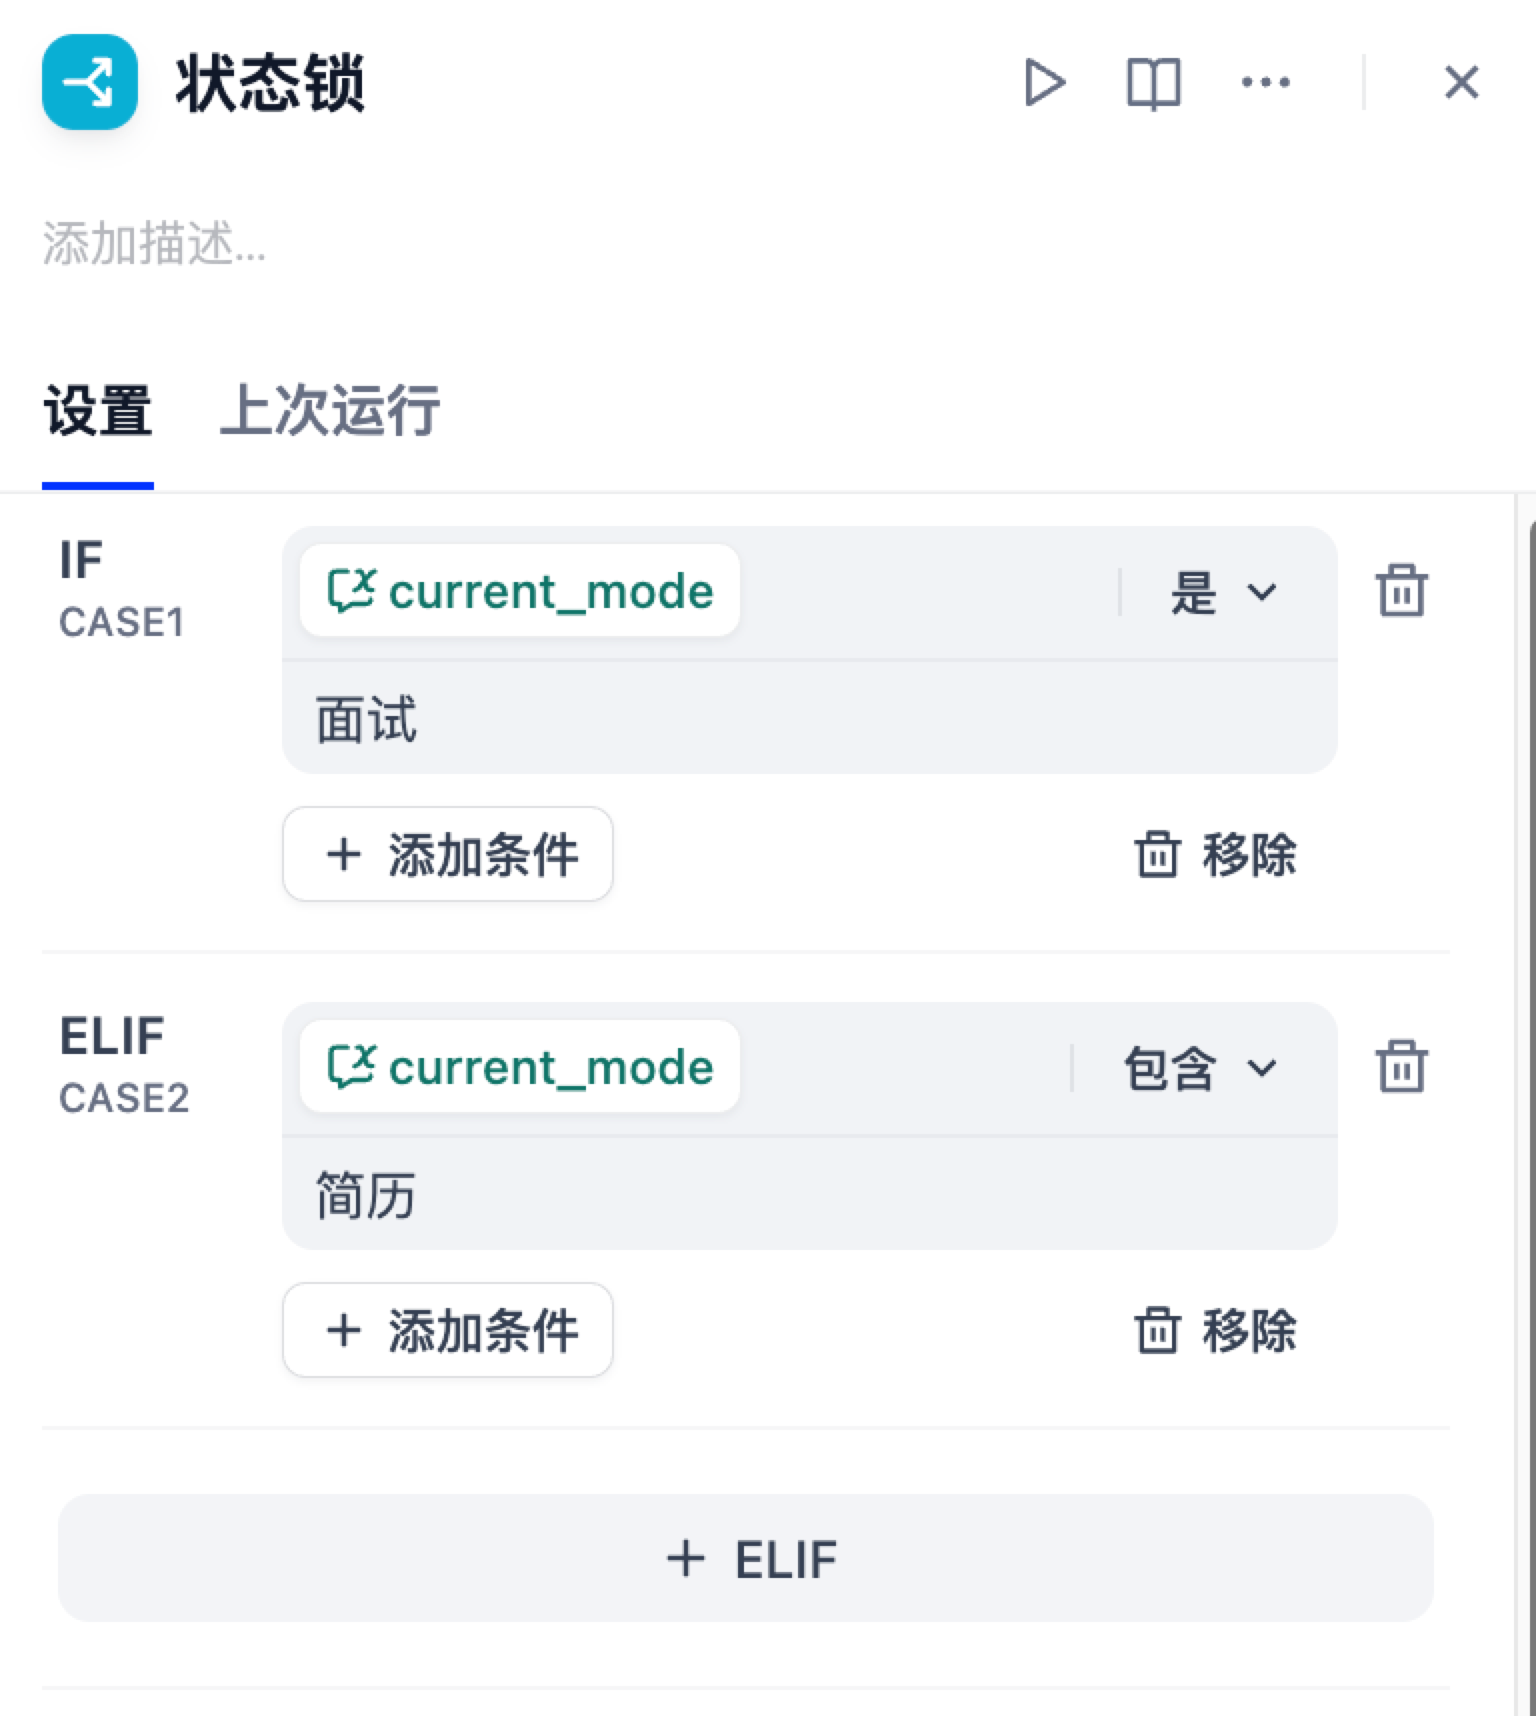
状态锁是整个多轮对话系统的“免检快速通道闸机”:
- IF (CASE 1):
conversation.current_mode是面试
👉 直接放行:说明该用户已经在面试进程中,当前发来的消息必定是对上一道面试题的回答,直接跳过意图识别大模型,直达面试处理引擎。 - ELIF (CASE 2):
conversation.current_mode包含简历
👉 直接放行:说明用户正在进行简历优化,直接流向简历优化流水线。 - ELSE(默认兜底):
current_mode为空(首次新会话或上一轮刚刚结束)
👉 拦截分流:引导至关卡三的「意图识别」大模型进行身份判定。
[!TIP] 为什么要加状态锁?
如果没有状态判断,在模拟面试第 3 轮时,候选人回答:“我上一份工作主要负责用 Python 编写数据清洗脚本……”,意图识别模型可能把它误判成新的简历咨询。保留当前模式可以减少这类错误,但仍要为结束和切换任务设计明确出口。
关卡三:意图识别专家(LLM)的 提示词设计
对于新进来的首次会话,系统必须判断用户的真实诉求。
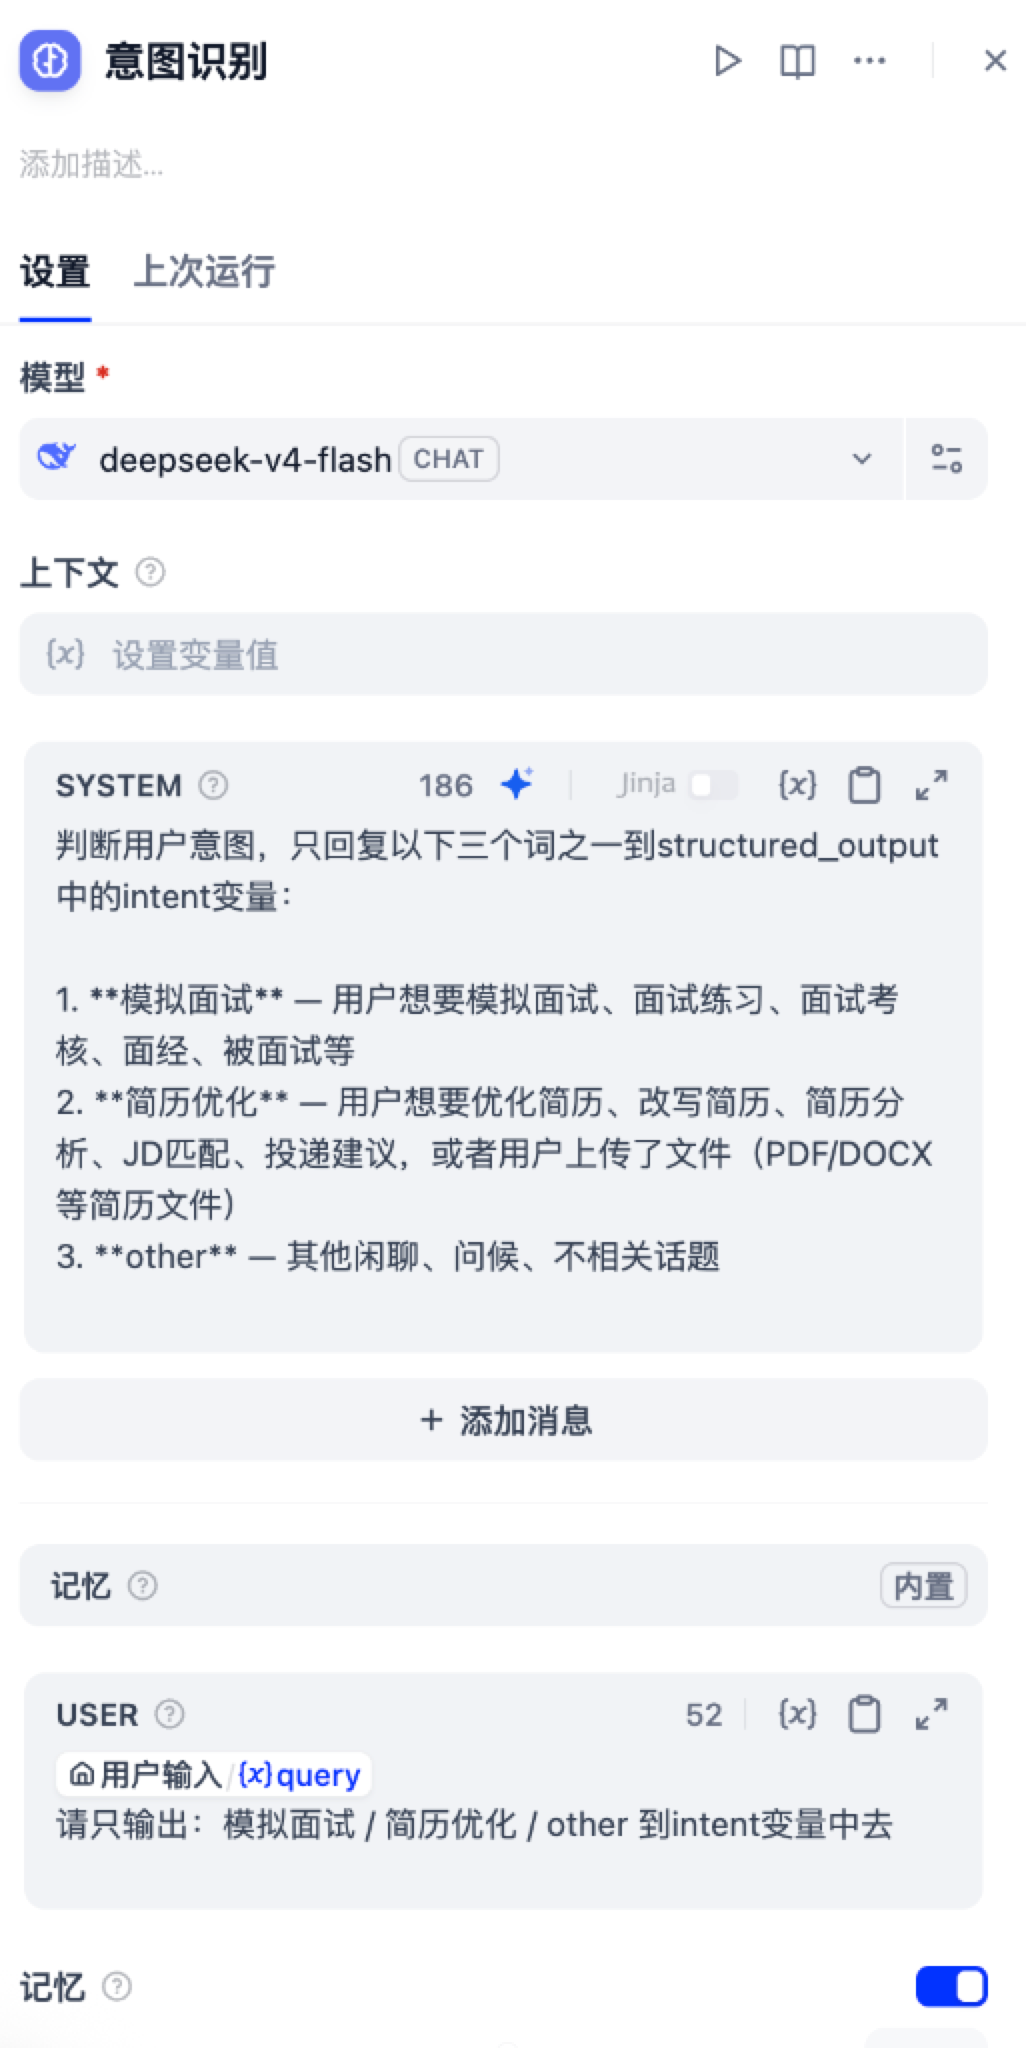
1. 模型选型:快速轻量模型(deepseek-v4-flash)
意图分类的输出较短,可以先用响应较快、成本较低的模型测试。是否满足要求,应看固定用例中的分类结果与实际耗时,不预设所有请求都能在某个毫秒数内完成。
2. 提示词设计解密(Prompt Engineering)
markdown
# SYSTEM 角色设定
判断用户意图,只回复以下三个词之一到 structured_output 中的 intent 变量:

1. **模拟面试** —— 用户想要模拟面试、面试练习、面试考核、面经、被面试等
2. **简历优化** —— 用户想要优化简历、改写简历、简历分析、JD匹配、投递建议,或者用户上传了文件(PDF/DOCX 等简历文件)
3. **other** —— 其他闲聊、问候、不相关话题
markdown
# USER 输入绑定
{{#1782652624715.query#}}
请只输出:模拟面试 / 简历优化 / other 到 intent 变量中去
大模型“结构化输出(Structured Output)”第一性原理
后续节点需要读取字段时,可以使用**结构化输出(Structured Output)**约定格式,减少额外解析。
1. 问题分析:为什么纯文本输出是下游节点的“噩梦”?
如果我们只靠在 Prompt 里写“请只输出'模拟面试'四个字,不要输出任何废话”,大模型由于其概率性自回归文本接龙的本质,往往会输出各种奇怪变体:
变体 A:"好的!根据您的输入,意图分类为:模拟面试。"  ❌(下游 If-Else 判断 == '模拟面试' 失败!)
变体 B:"```json {"intent": "模拟面试"} ```"      ❌(带有 markdown 代码块标记,解析崩溃!)
变体 C:"模拟面试\n"                              ❌(多了一个看不见的换行符,匹配失败!)
这些输出在含义上相近,但格式不同。程序若直接按固定字符串判断,就可能选错分支或读取失败。
2. 什么是真正的结构化输出?(Schema-Constrained Decoding)
结构化输出为结果约定字段、类型和取值范围。支持原生约束的模型可以在生成阶段限制格式;不支持时,平台可能把规则写进提示词,再解析返回内容。不能假定所有模型都采用相同的底层实现:

- 约束的边界:格式规则有助于程序读取结果,但仍要处理拒答、截断、解析失败和业务判断错误。即使类型完全正确,也要检查取值是否符合任务要求。
3. Dify 中的结构化输出配置实操
在 Dify 的意图识别节点中,我们通过可视化面板与 JSON Schema 进行了严密的双字段约束:
① 变量与重试配置面板
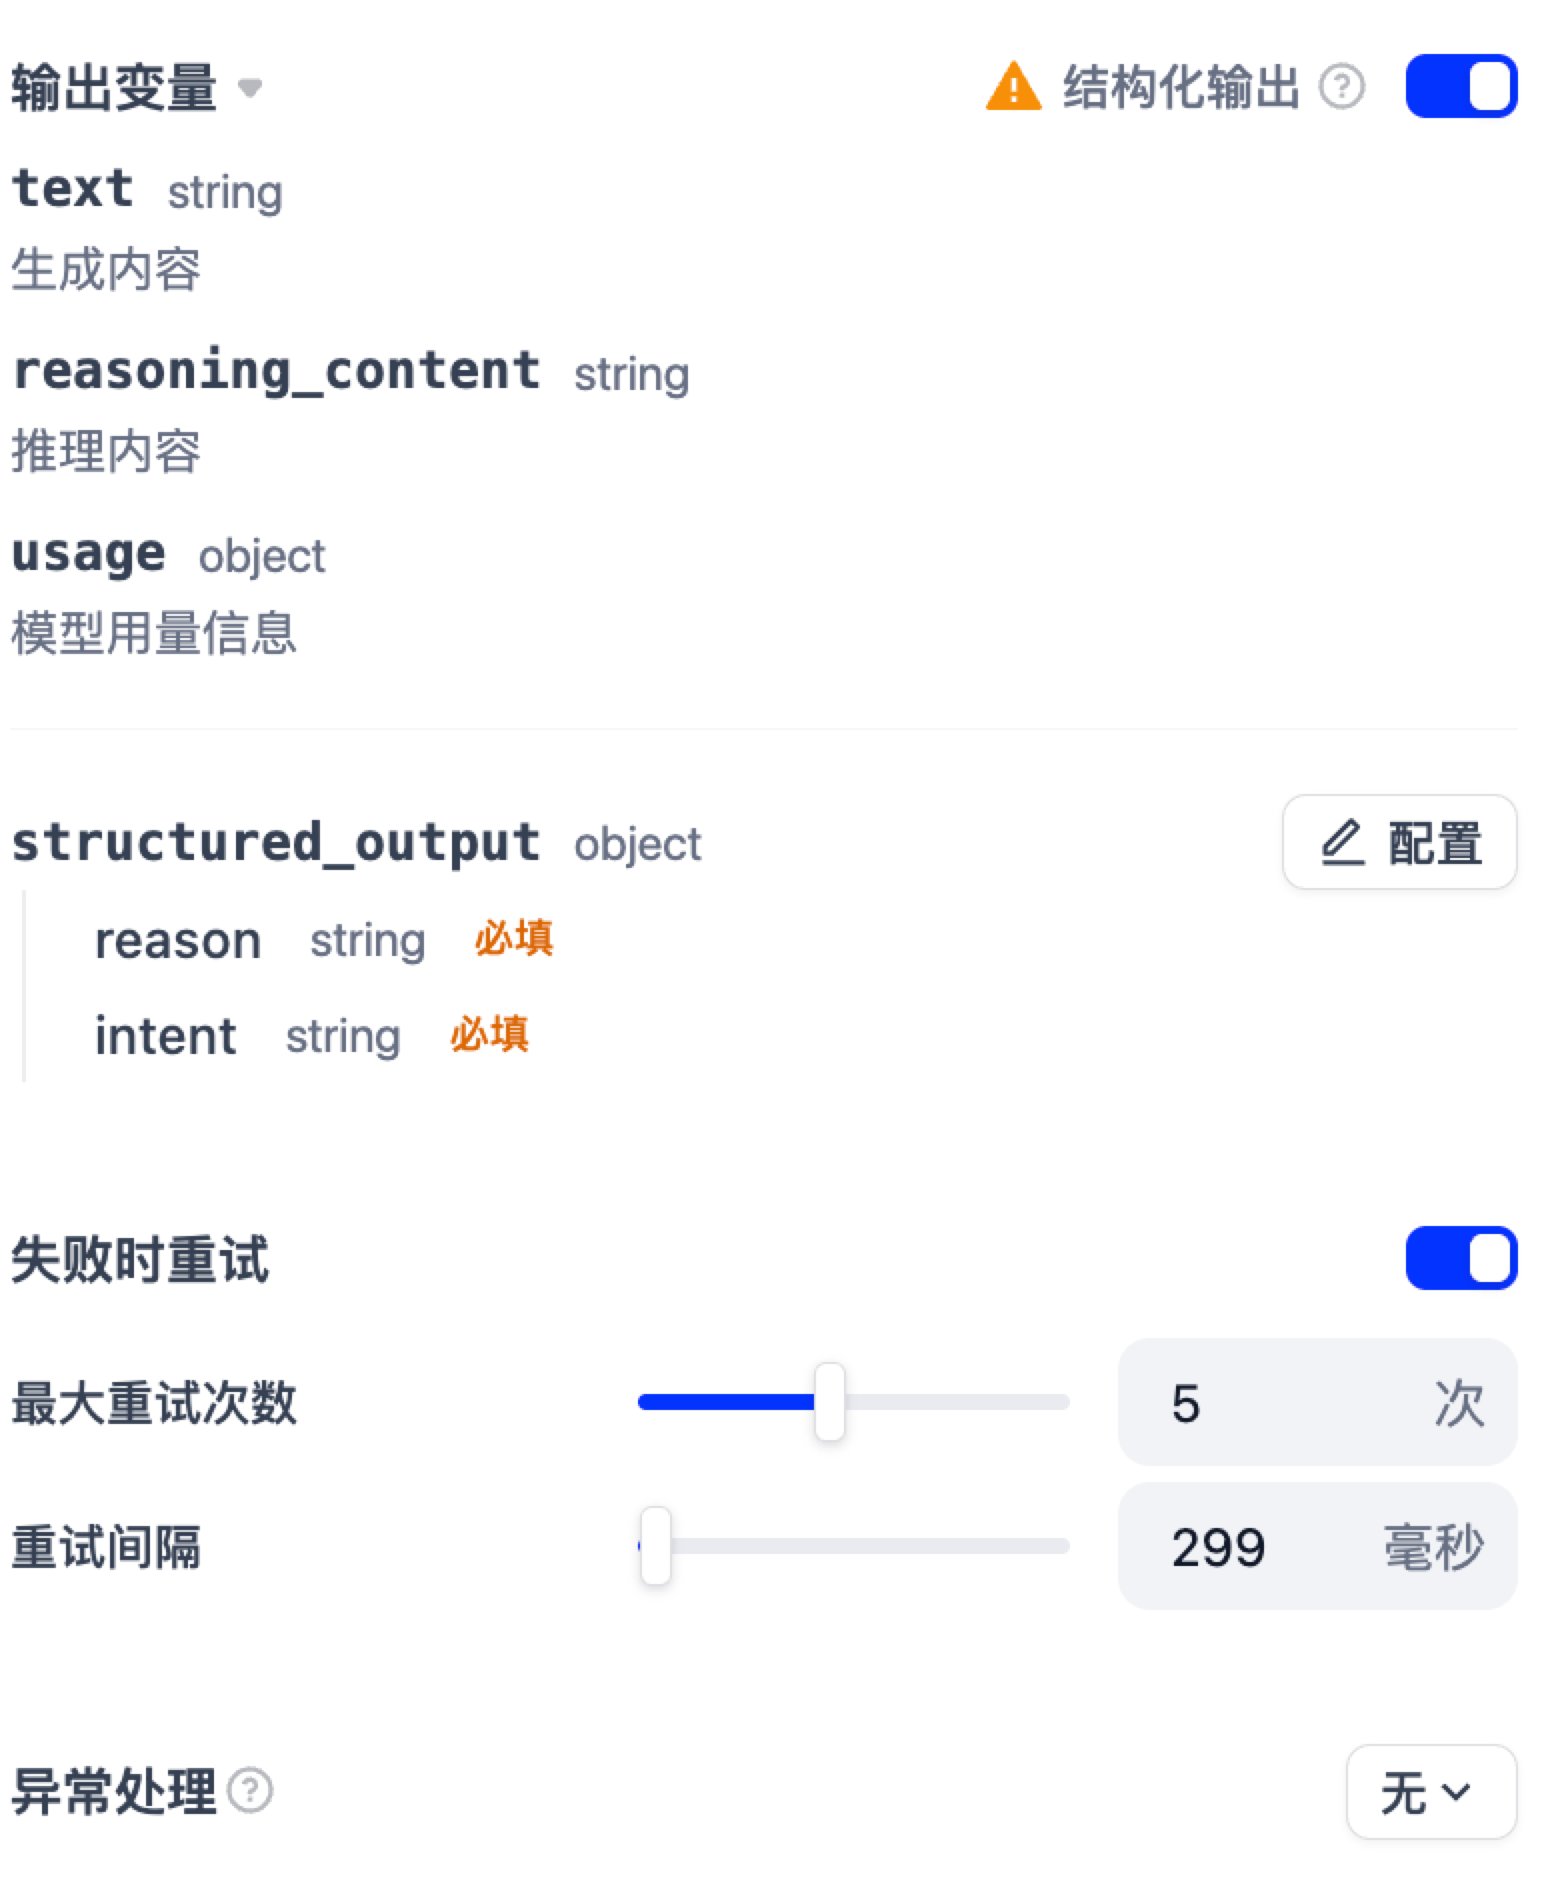
- 输出变量:自动生成
structured_output对象; - 失败重试(Retry Mechanism):开启重试,设置 最大重试次数 5 次,重试间隔 299 毫秒。即使遇到罕见网络抖动或模型偶发异常,系统也会自动重试修复,重试仍失败时应进入错误处理分支,而不是无限等待。
② JSON Schema 契约定义
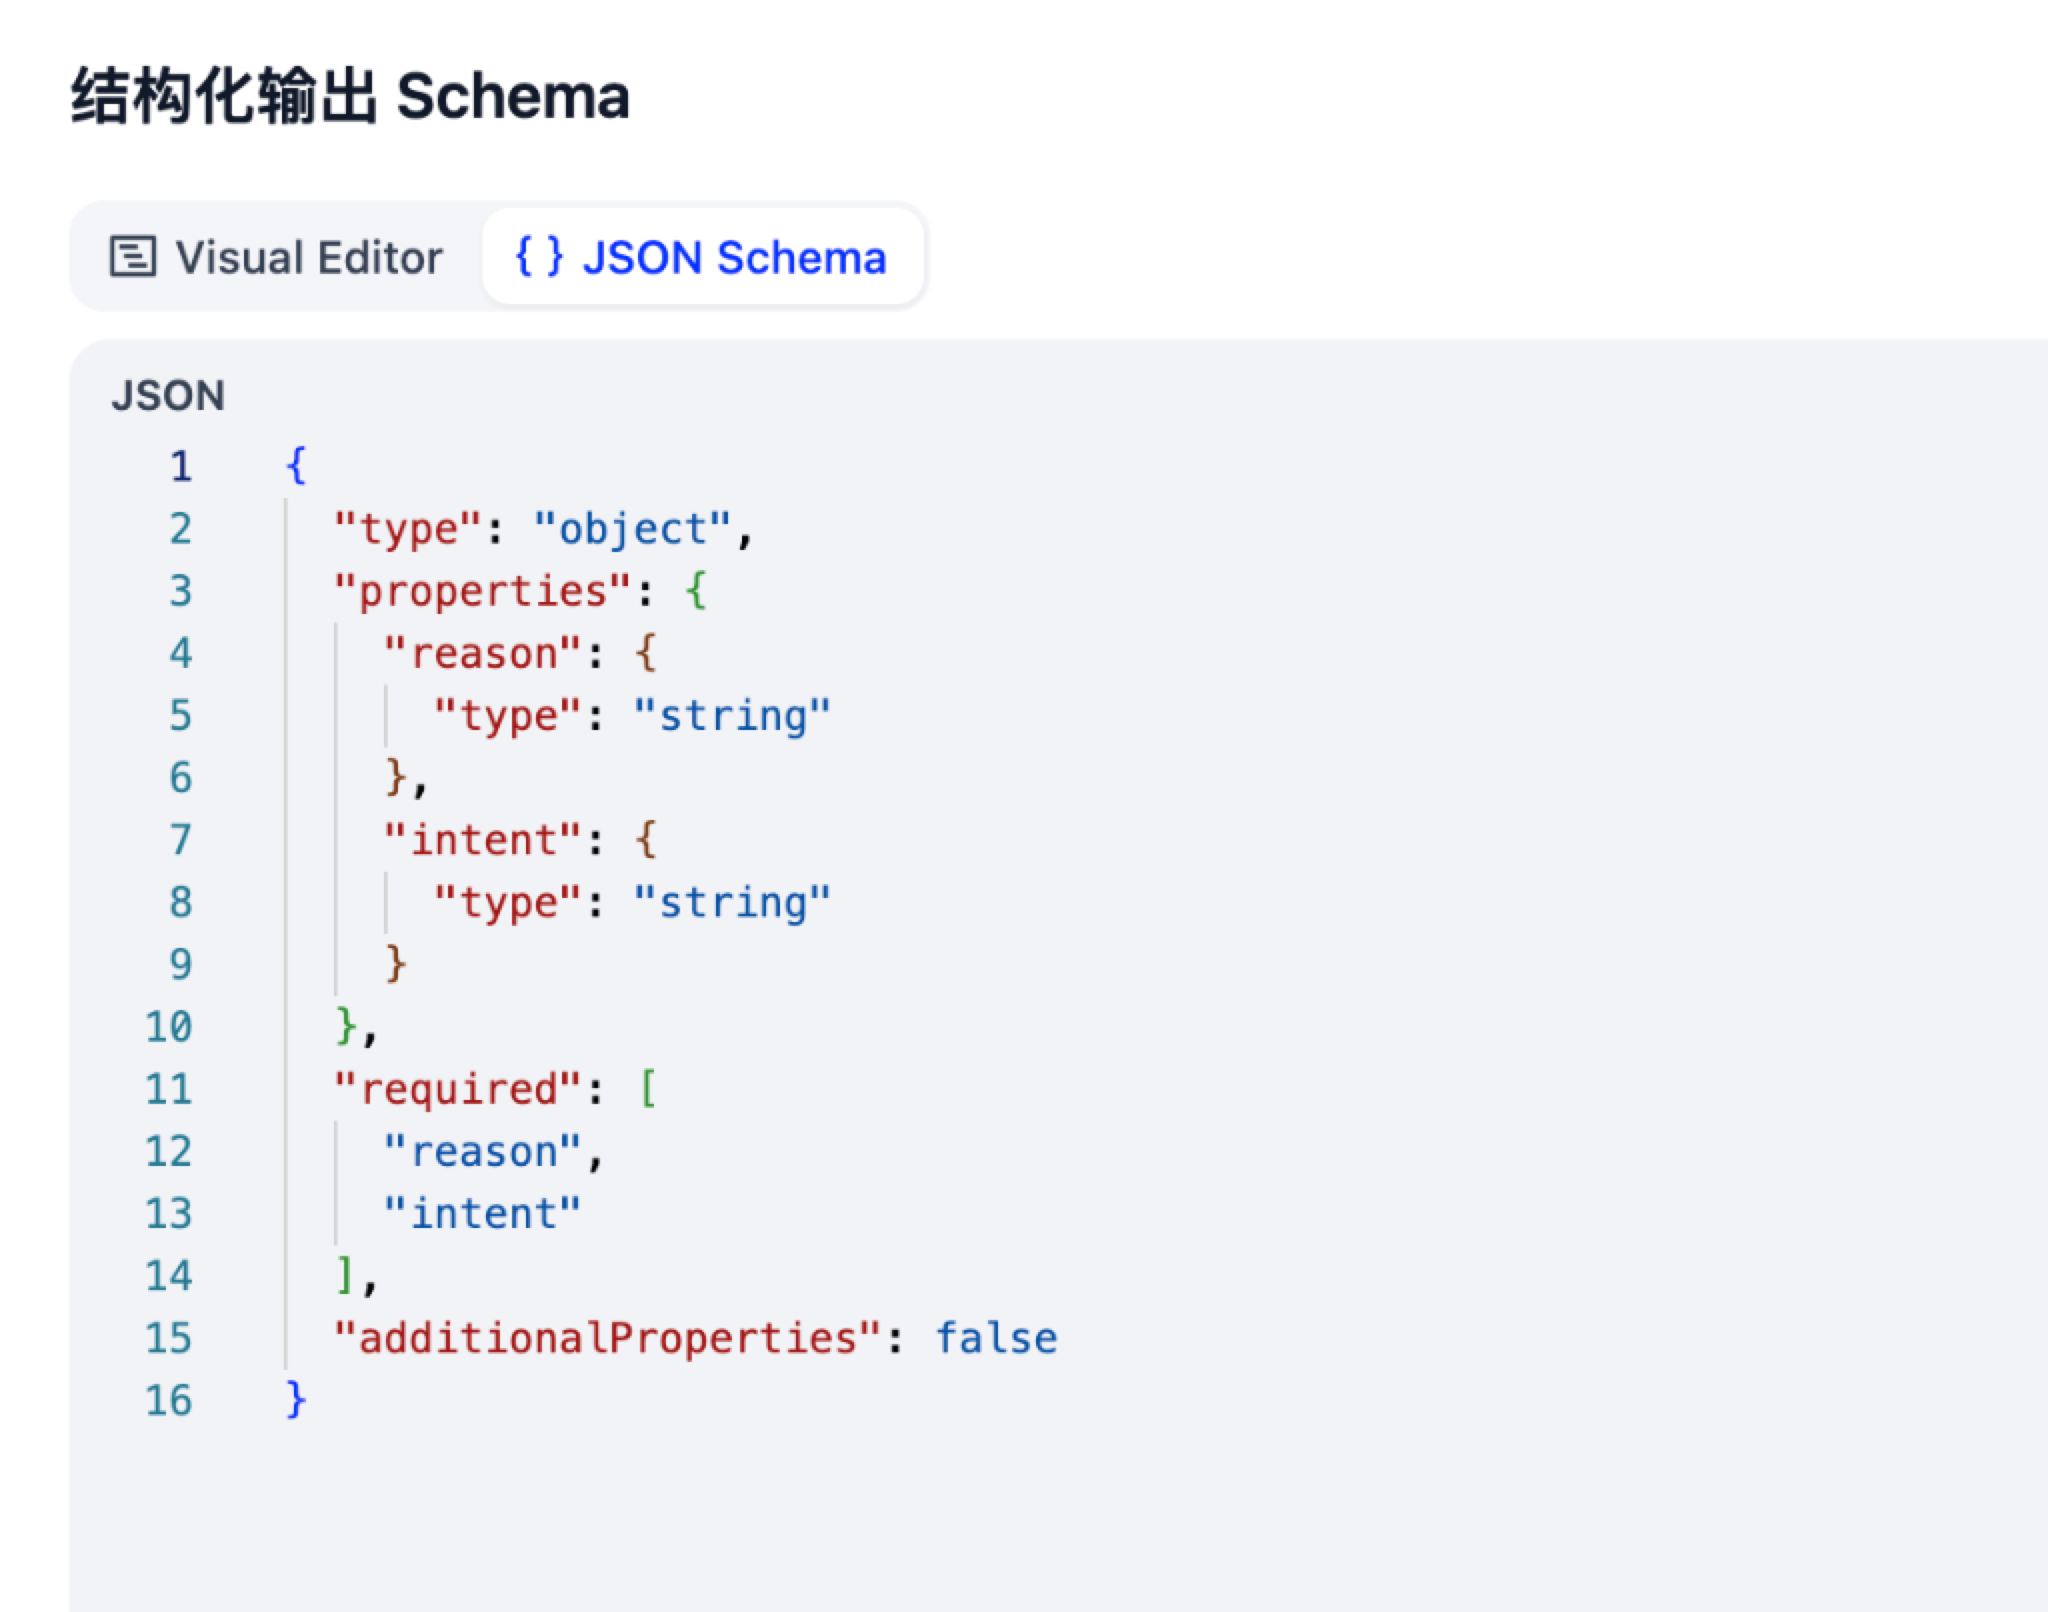
json
{
  "type": "object",
  "properties": {
    "reason": {
      "type": "string"
    },
    "intent": {
      "type": "string"
    }
  },
  "required": [
    "reason",
    "intent"
  ],
  "additionalProperties": false
}reason(思考理由,String):强制要求大模型在给出结论前先写出思考理由,便于排查分类错误;它不是准确率保证;intent(核心意图,String):精准承载模拟面试、简历优化或other;required: ["reason", "intent"]:两个字段均为必填;additionalProperties: false:严格禁止大模型自行发挥输出多余的字段。
关卡四:意图分支(If-Else)与状态动态加锁
读取并校验 structured_output.intent 后,意图分支节点按照配置的条件选择后续路径:
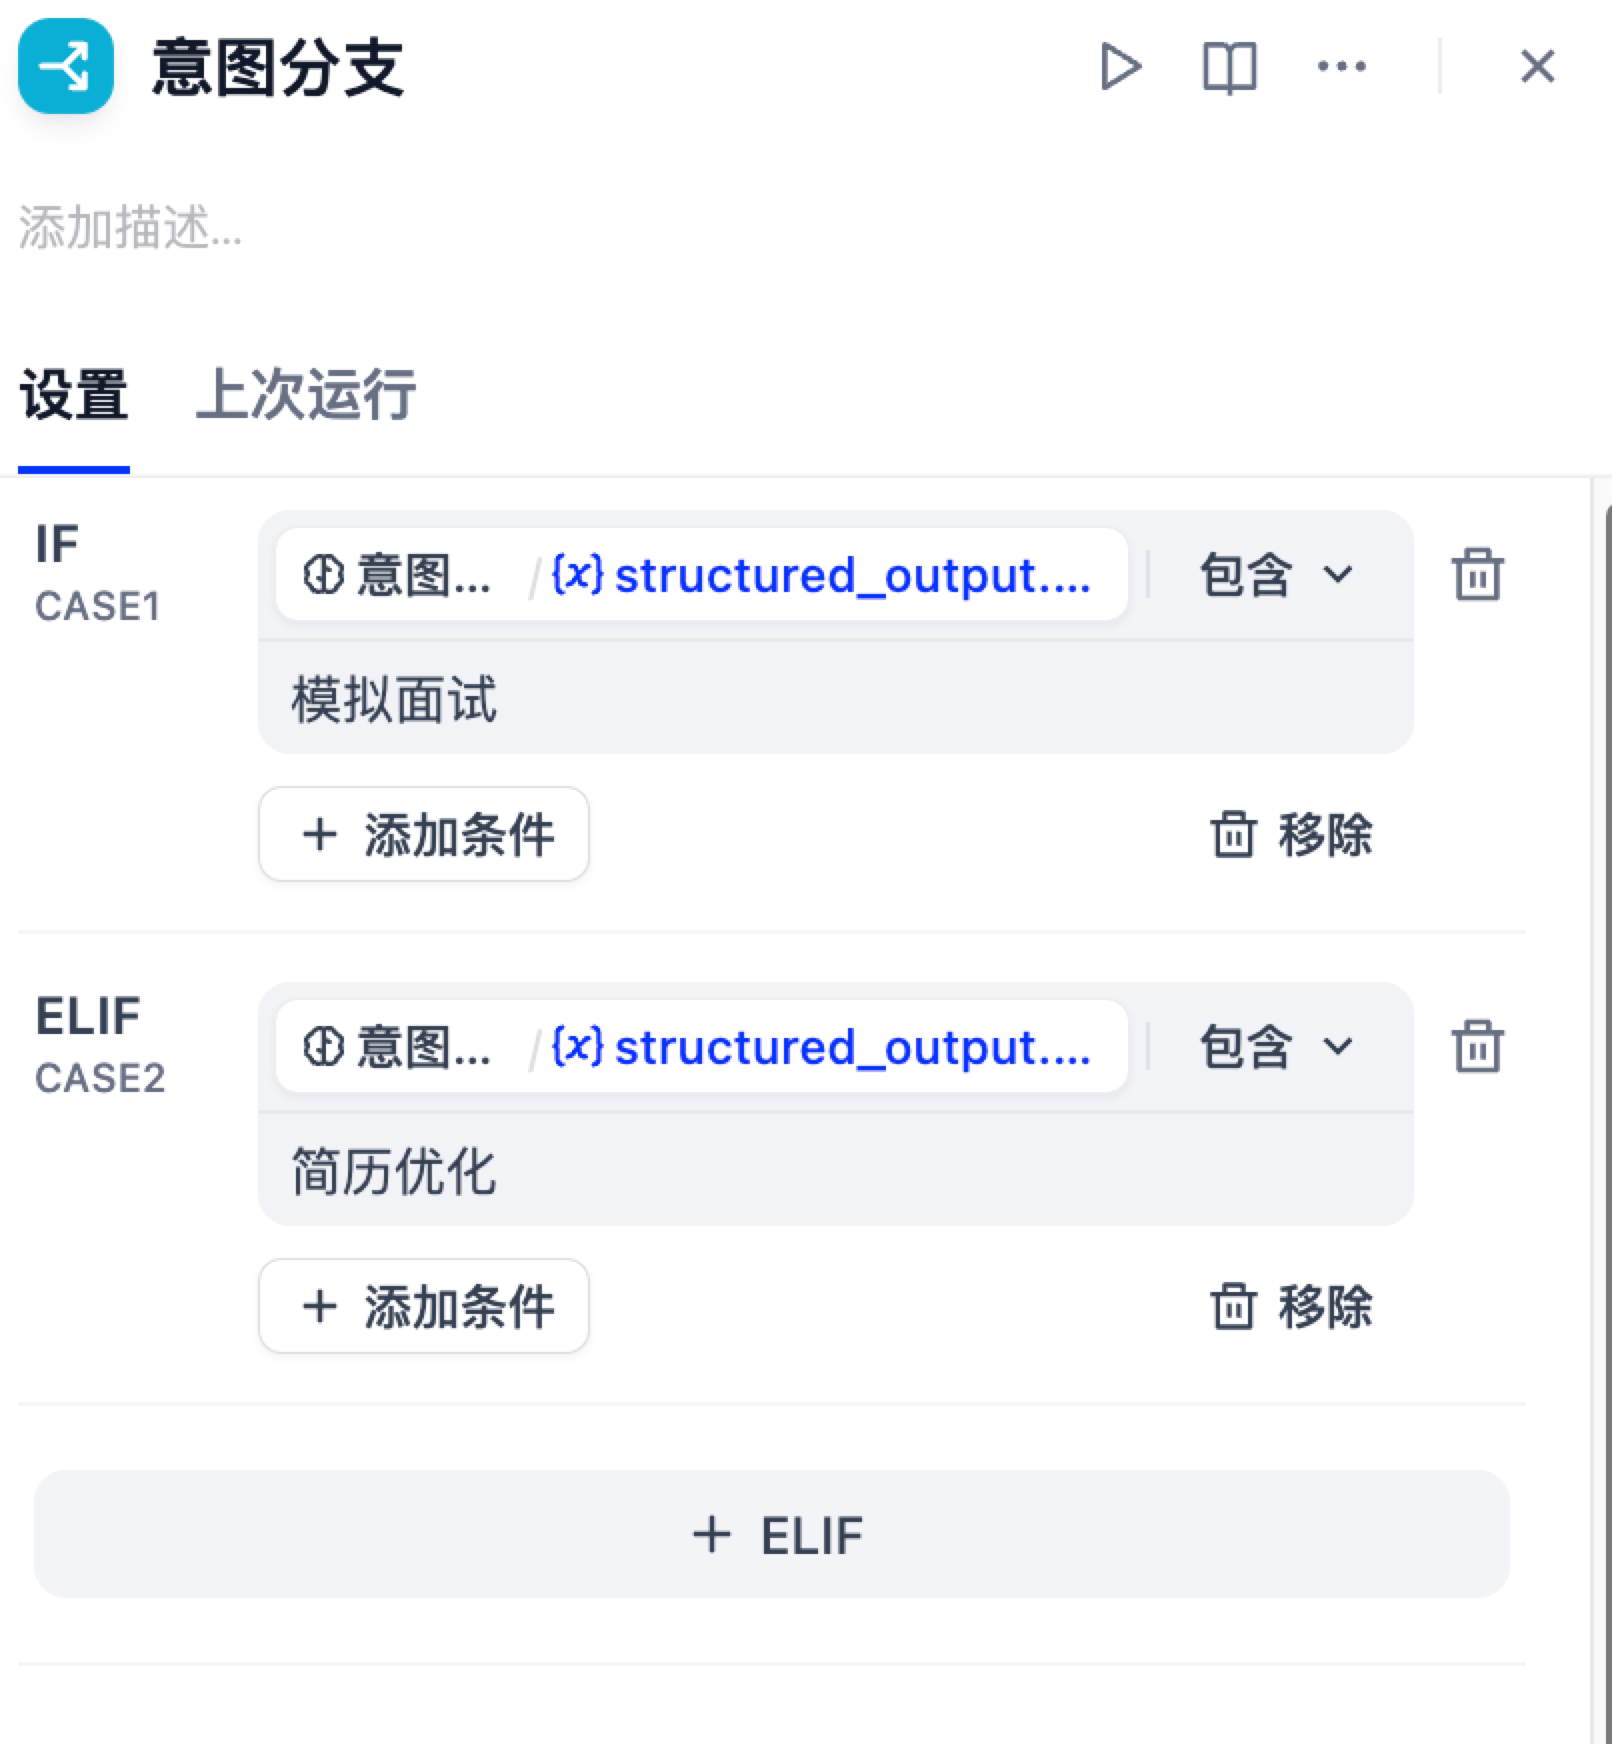
1. 三大分支路由逻辑
- CASE 1(模拟面试):
- 条件:
意图识别.structured_output.intent包含模拟面试 - 流向:触发
设为面试(Assigner 节点),写入conversation.current_mode = '面试',为会话戴上“面试手环”;
- 条件:
- CASE 2(简历优化):
- 条件:
意图识别.structured_output.intent包含简历优化 - 流向:触发
设为简历(Assigner 节点),写入conversation.current_mode = '简历',为会话戴上“简历手环”;
- 条件:
- ELSE(默认闲聊/引导):
- 流向:触发
闲聊引导(Answer 节点),输出开场白并温和提示用户:“你好。我是「面必过」AI 求职助手,请告诉我你想进行【模拟面试】还是【简历优化】~”。
- 流向:触发
分类结果还需要业务校验
登记表要求“年龄必须填数字”,只说明格式合格,并不能证明年龄填得真实。结构化输出也是如此:字段能解析,不代表意图判断正确。
本例只接受三个意图,建议在 intent 的规则中增加枚举约束,并在分支前检查取值是否属于“模拟面试、简历优化、other”。遇到空值、未知选项或解析失败,应回到说明用途的回复,而不是随便进入一个业务分支。已有流程使用“包含”判断时,还要留意否定句;后续改造可用枚举校验后的精确相等判断。
状态优先也需要出口。用户明确说“结束面试”或“换成简历优化”时,应设计结束或切换流程;否则当前模式一直被保留,用户会感觉无法退出。改造时把这些输入与普通回答分开测试。
可以准备四组用例:明确选择任务、含糊请求、面试中的普通回答、主动结束或切换。对照每组输入记录分类结果、进入分支和运行后的状态。若改动提示词,这组用例可以再次使用,判断修改是否改善了整体表现。
不同模型在 Dify 中实现结构化输出的方式可能不同,原生支持和通过提示词约束的可靠性也不同。参见 Dify LLM 节点说明。
为路由保留“无法判断”的出口
意图分类不应强迫每句话都落入某个业务。像“帮我看看”“继续吧”这样的输入,如果缺少会话背景,就没有足够依据判断是面试还是简历优化。此时返回补充问题,比随意选择一个分支更可靠。
可以让分类结果同时包含 intent、confidence 和 reason。confidence 只用于辅助设定阈值,不代表客观概率;真正的业务规则仍应明确:未知枚举、字段缺失、低于阈值或理由与结果矛盾时,统一进入澄清分支。日志中保留原输入和最终路由,便于复查误判。
状态切换也要写成显式规则。用户从面试转到简历优化时,要决定保留简历和岗位要求,还是重新确认;用户只说“重新开始”时,则需要说明会清空哪些资料。把这些规则固定下来后,可用“开始—切换—退出—再次开始”的连续用例做回归,避免单句分类正确但整段会话失控。
本节回顾
会话状态负责延续当前任务,意图分类负责识别新的请求。结构化输出便于取值,但分类正确性和异常出口仍需单独检查。
继续阅读:4.6 模拟面试与问答复盘。