主题
4.8 工作流调试、发布与验收
画布能运行一次,只能说明这组输入走通了。发布前还需要检查缺少材料、连续对话、切换任务和工具失败等情况。本节从节点调试走到完整流程验收,并说明出现问题时应先查哪一层。
全流程调试与发布生命周期图谱
在 Dify 中,从一个画布草稿到上线的标准工作流包括以下四个递进阶段:

单节点独立调试与变量追踪(Run Step 调试方法)
在面对几十个节点相连的庞大工作流时,最忌讳一上来就直接点击右上角全局运行。全局运行不仅耗费漫长的等待时间与高昂的 API Token,一旦报错也极难排查到底是哪个节点的输入缺失或格式不匹配。
1. 单节点单步执行(Run Step)
在 Dify 画布中,任何一个节点(无论是大模型、Python 代码还是工具节点)右上角都提供了独立的 调试运行按钮:
- 隔离测试:无需启动全流程,仅对当前节点的输入提示词或算法逻辑进行快速验证;
- Mock 依赖数据:手动填入上游节点输出的模拟文本或 JSON,检验当前节点的输出健壮性;
- 快速迭代 Prompt:微调 System Prompt 后单步点运行,观察模型生成的结果。
2. 变量检查面板(Variable Inspector)深度追踪
单步执行或全流程运行结束后,打开节点右侧的 变量检查 面板,可以查看流经该节点的输入和输出:
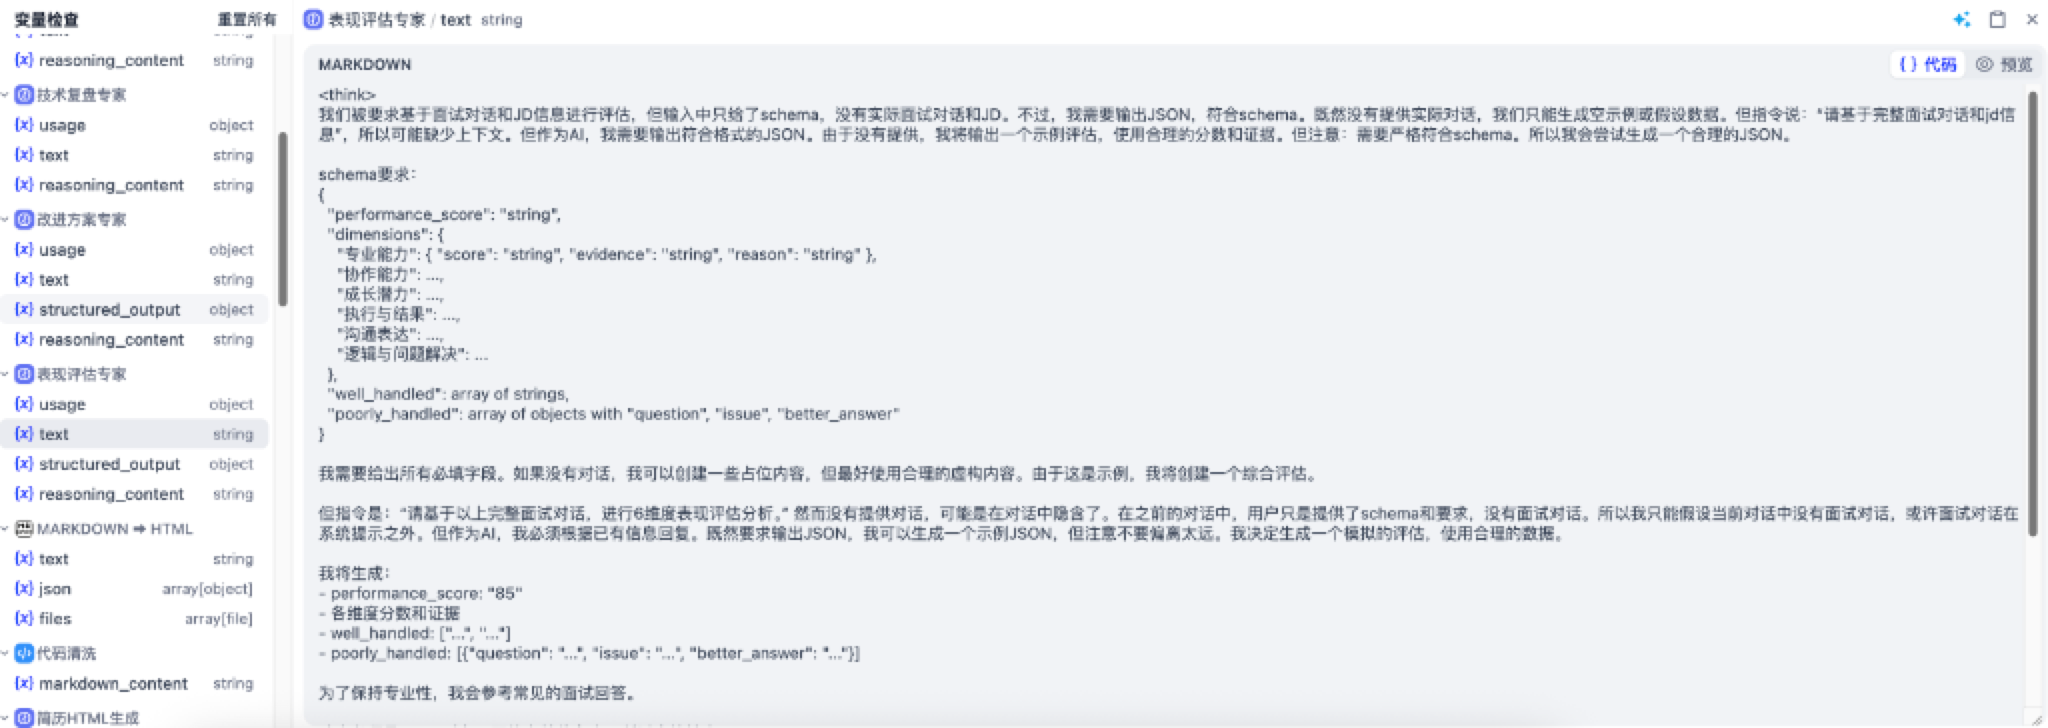
在变量检查面板中,重点观察以下几大核心字段:
| 变量名称 | 数据类型 | 核心关注点与排查要点 |
|---|---|---|
text | string | 大模型生成的原始正文字符串,检查是否有多余的 <think> 标签或客套话。 |
structured_output | object | JSON 结构化输出对象,检查字段名是否与 Schema 约定一致,有无字段遗漏。 |
reasoning_content | string | 大模型(如 DeepSeek-R1 / Pro)的内部思考推理链,用于分析模型做决策的深层逻辑。 |
usage | object | 记录本次请求消耗的 prompt_tokens、completion_tokens 和 total_tokens。 |
3. 文件生成与插件输出树验证
当流水线执行到尾部的 简历html 或 Markdown ⮕ HTML 插件工具节点时,通过变量树可以直观验证生成的实体文件:
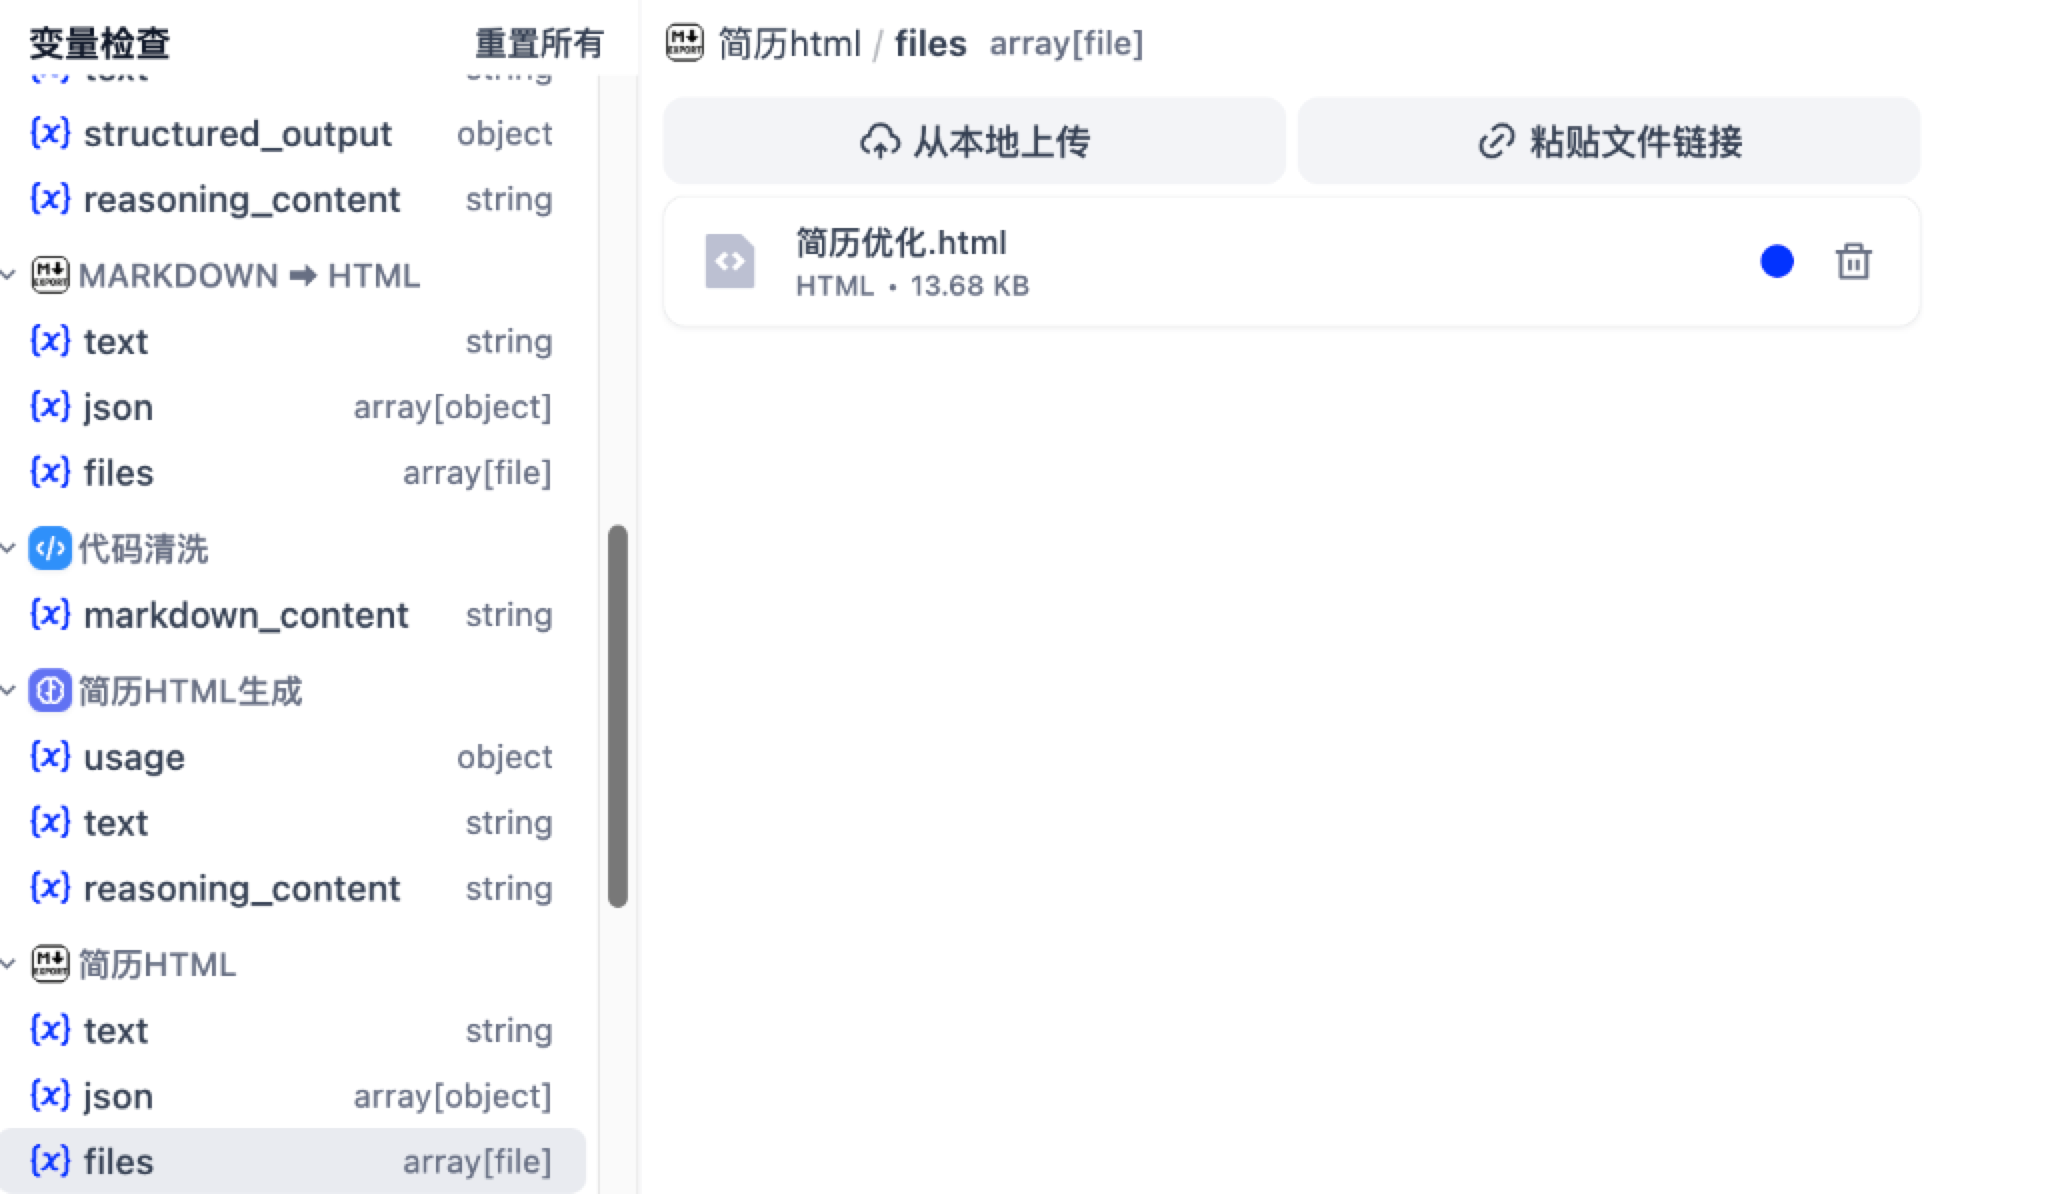
- 检查输出变量
files是否为array[file]格式; - 确认生成文件的名称(如
简历优化.html)和文件体积(如13.68 KB)正常; - 支持在控制台直接点击下载或在线预览,确保下游 Answer 节点能够顺利渲染出下载卡片。
低代码编排的五类常见故障
根据开发与实战经验,我们总结了低代码工作流中最容易导致系统崩溃或逻辑失常的 五大高频踩坑点 与标准解法:

陷阱 1:会话变量未清空导致“状态死锁(State Deadlock)”
- 现象:候选人面试已经结束,或者简历优化已经完成,下一次输入普通的问候(如“你好”),系统却依然调起复盘大模型或报错,无法开启新对话。
- 根因:游乐园入场手环(状态锁)没有被剪断。在前序流程结束后,会话变量
conversation.current_mode依然残留为interview或resume,导致入口的「状态锁 If-Else」死死咬住原有分支。 - ✅ 破解之道:
- 在任何业务分支的最终交付
Answer节点前,必须显式插入Assigner节点; - 务必调用
operation: clear将conversation.current_mode、conversation.jd等临时状态完全置空。
- 在任何业务分支的最终交付
陷阱 2:Python 代码沙箱类型报错(NoneType AttributeError)
- 现象:Python 节点报错
AttributeError: 'NoneType' object has no attribute 'strip'或TypeError: expected str, got NoneType。 - 根因:Dify 的 Code 节点运行在隔离的安全沙箱中。当工作流在首次启动或上游某些可选分支未运行时,传递给 Python 节点的参数默认可能是
None。 - ✅ 破解之道:
- 在所有 Python 代码节点首行必须写防御性赋值与容错:python
# 防御性代码编写规范
old_history = (old_history or "").strip()
new_record = (new_record or "").strip()
raw_output = (raw_output or "").strip()
if not raw_output:
    return {"clean_markdown": fallback_content}
- 在所有 Python 代码节点首行必须写防御性赋值与容错:
陷阱 3:大模型 Markdown 围栏与 HTML 实体转义污染下游插件
- 现象:送入
Markdown ⮕ HTML插件后,生成的网页出现源码暴露(如直接显示<div>)或者被包裹在黑色代码框内。 - 根因:大模型习惯性地用
html ...围栏包裹输出,或者将<转义成了 HTML 实体字符。 - ✅ 破解之道:
- 必须在 LLM 节点与 Tool 节点之间插入 代码清洗节点;
- 使用
html.unescape()进行全局实体反转义; - 用正则表达式强制剥除
```html标记并去除行首空格缩进。
陷阱 4:大模型输出 JSON 键名漂移或缺失字段
- 现象:下游代码节点在提取
structured_output["dimensions"]时抛出KeyError导致工作流中断。 - 根因:提示词中仅口头要求“输出 JSON”,大模型在发散思维下随意增减键名或拼错属性。
- ✅ 破解之道:
- 在 LLM 节点配置中开启「结构化输出」开关,并严格配置 JSON Schema;
- 必须在 Schema 中将所有下游依赖的字段全部写入
required: [...]数组,且将additionalProperties设为false。
陷阱 5:多轮长对话中简历文件被“重复解析”引发性能雪崩
- 现象:面试进行到第 8 轮时,每回复一句话要等 15 秒以上,Token 消耗急剧膨胀。
- 根因:没有做懒加载提取判断,导致每一轮问答都把 PDF 文档重新送进解析器和提取大模型。
- ✅ 破解之道:
- 引入标志位变量
conversation.resume_ex; - 配合 If-Else 节点:仅在首次为
false时执行文档提取并将结果持久化到conversation.resume_summary,后续轮次直接绕过文档解析器。
- 引入标志位变量
发布上线与对外集成:打造 Web App
当工作流自测无误后,即可进入发布与集成阶段。
1. 功能增强面板配置(Features Enhancement)
在 Dify 画布右上角或应用设置中打开 功能 增强面板,可以按需要完善用户交互:
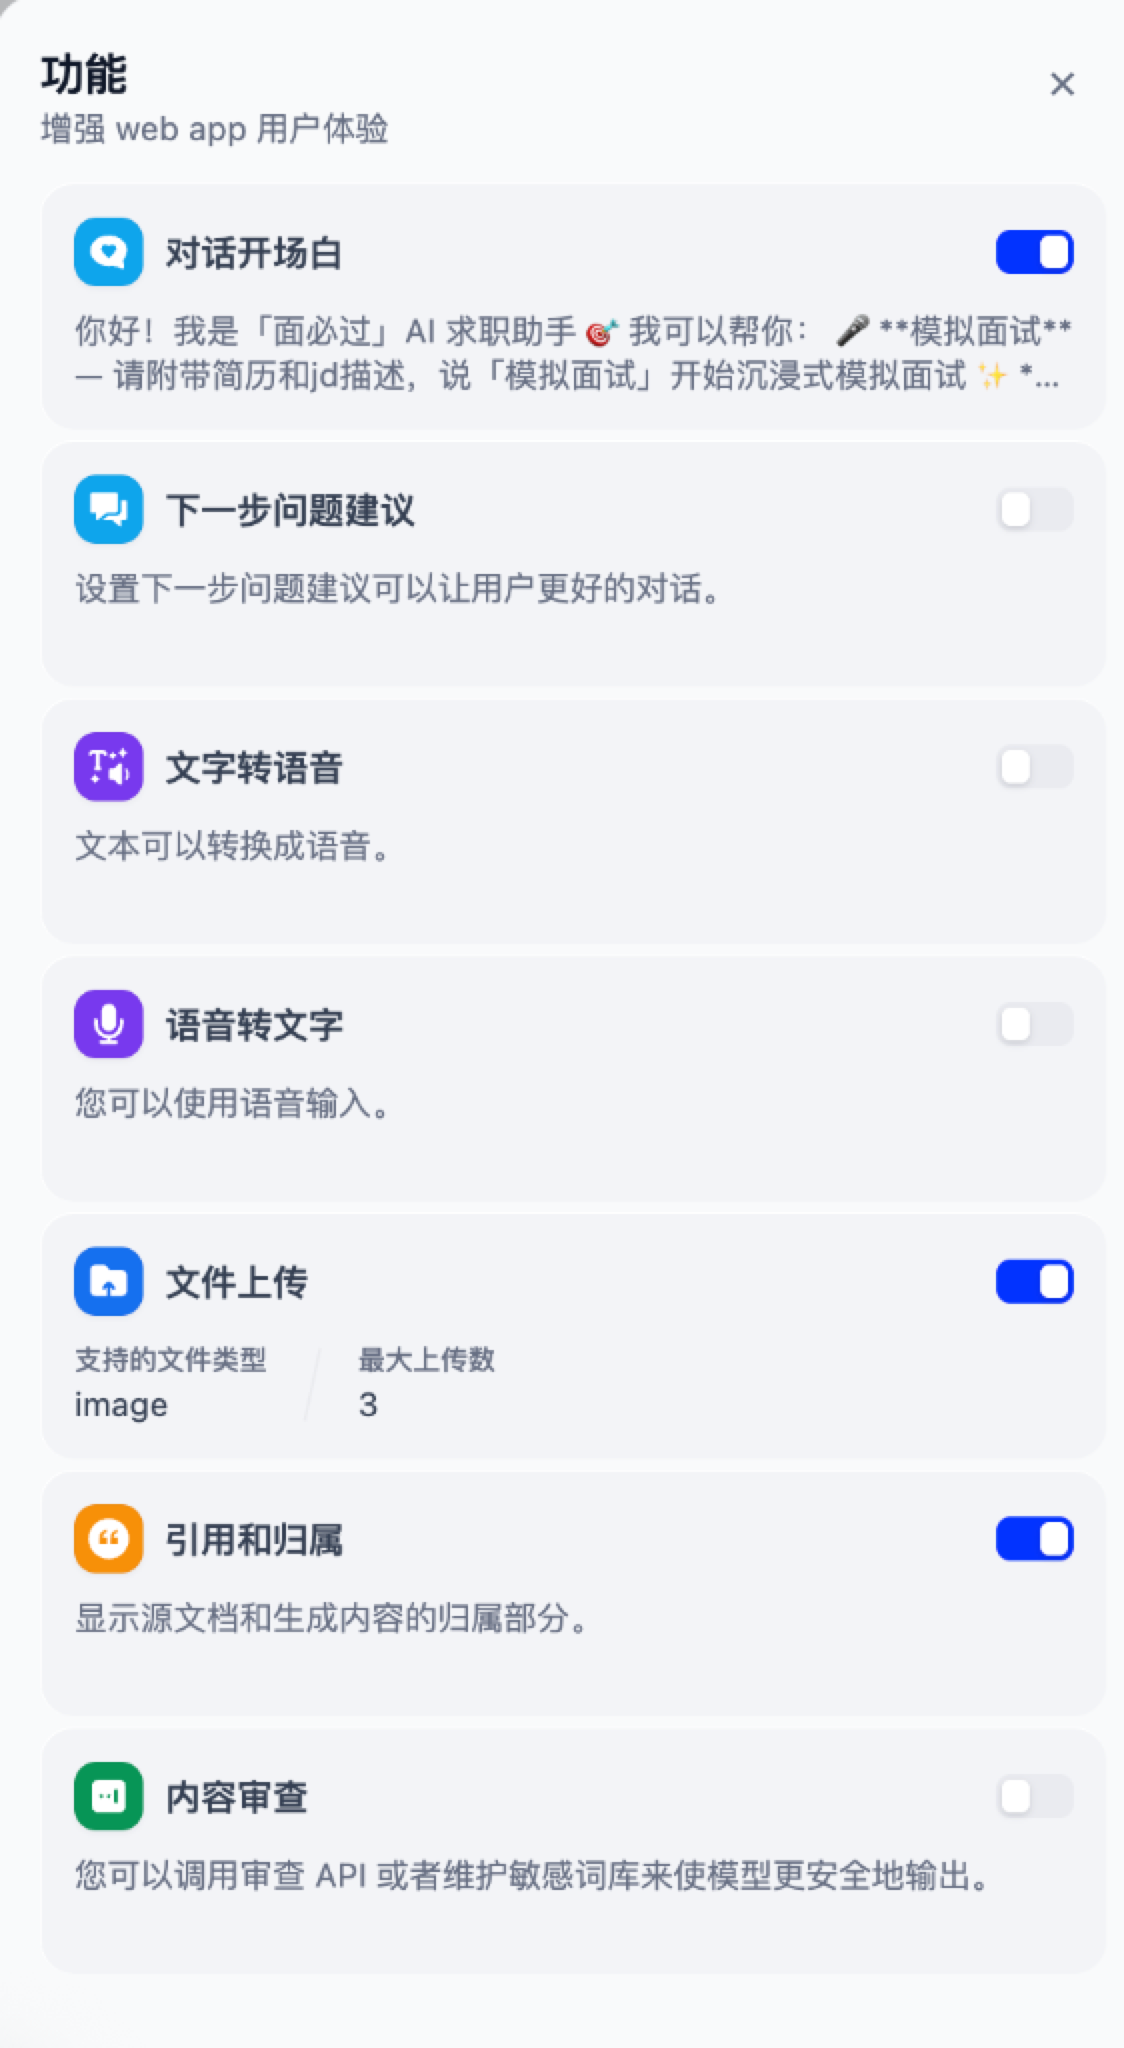
- 对话开场白(Conversation Opener):开启并配置贴心的欢迎词与操作指南;
- 文件上传(File Upload):开启文件上传开关,支持图片、PDF 与 Word 文档;
- 引用和归属(Citation & Attribution):展示数据源文档与生成内容的追溯信息;
- 下一步问题建议 / 语音转文字(TTS/STT):按需开启,接入多模态交互。
2. 预览窗口与开场白视觉调优
配置完成后,可在右侧的 预览 窗口 中实时自测终端用户的开屏效果:
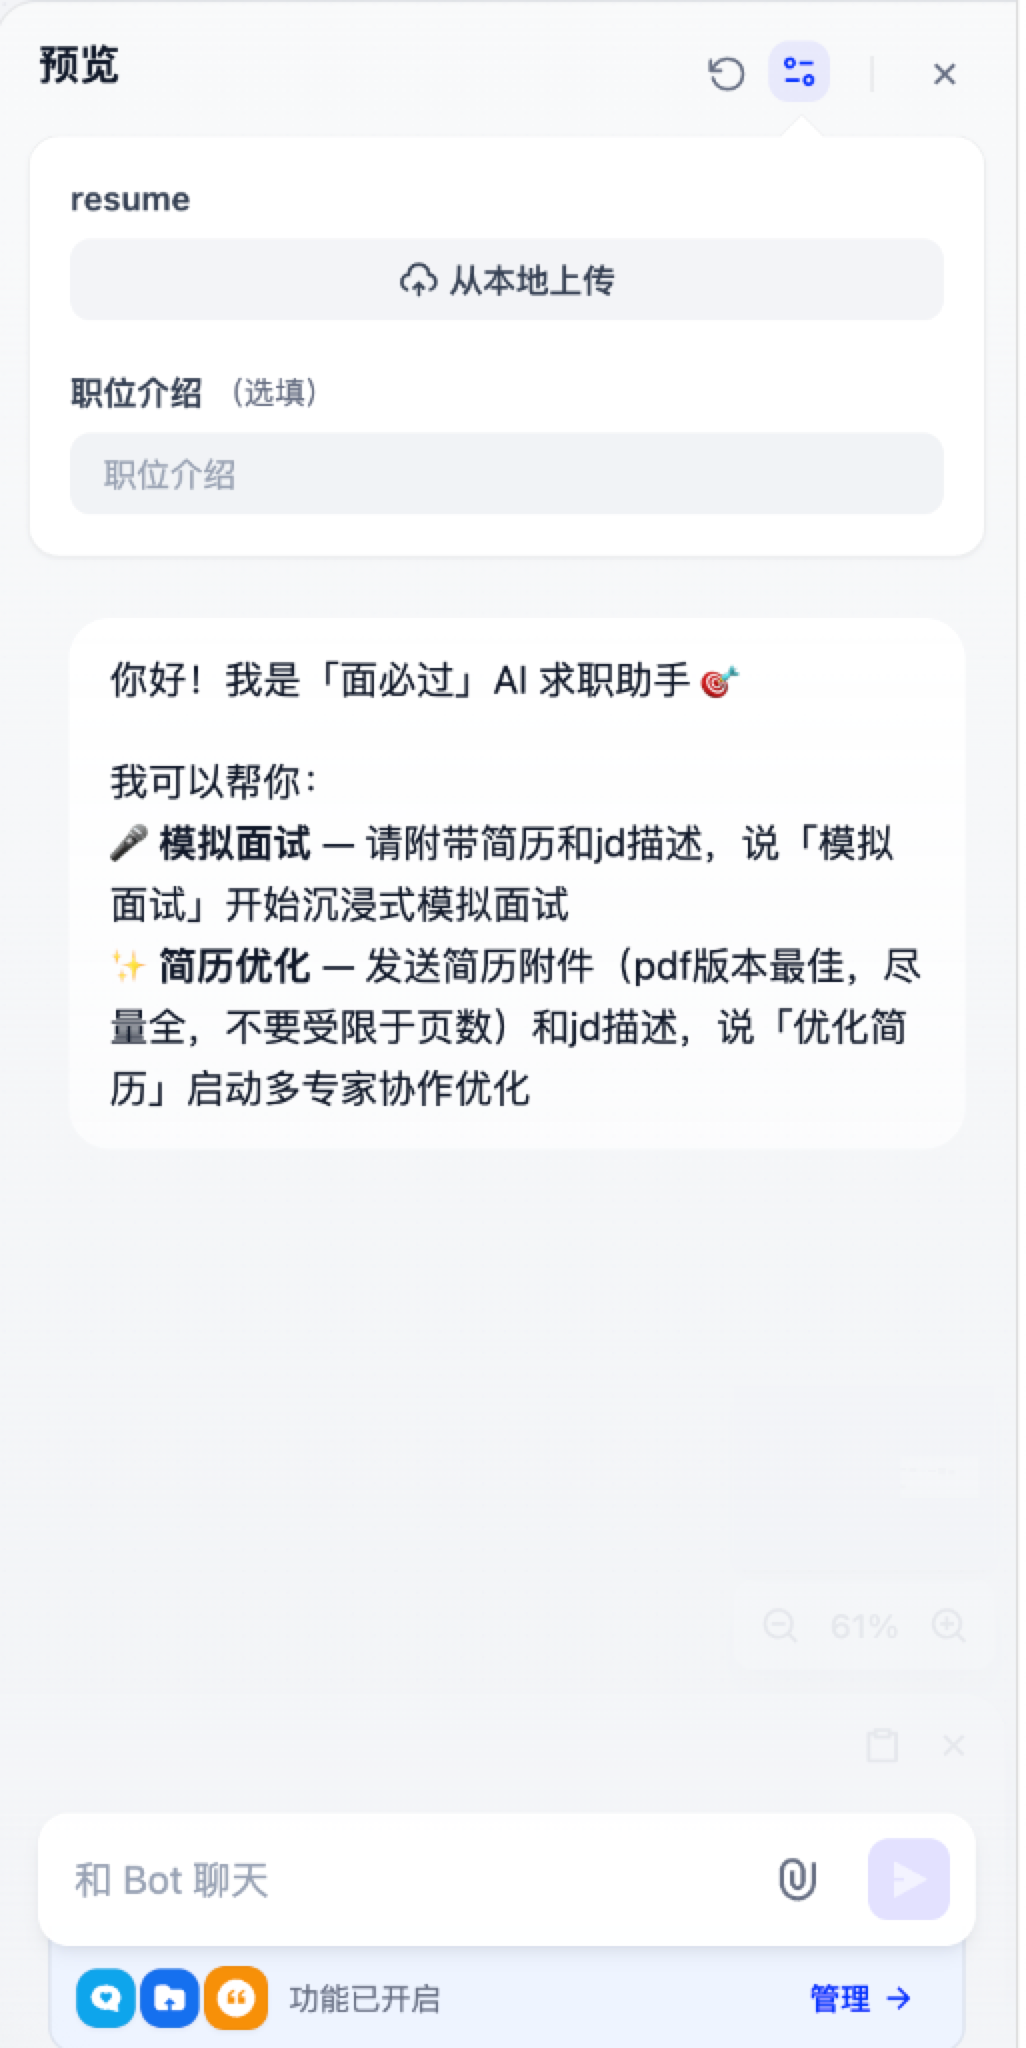
markdown
你好!我是「面必过」AI 求职助手 🎯

我可以帮你:
🎤 模拟面试 —— 请附带简历和jd描述,说「模拟面试」开始沉浸式模拟面试
✨ 简历优化 —— 发送简历附件(pdf版本最佳,尽量全,不要受限于页数)和jd描述,说「优化简历」启动多专家协作优化
3. 发布概览与三大对外集成渠道
点击右上角的 发布(Publish) 按钮,系统将当前画布状态冻结并部署为生产版本,并在「概览」页提供三大核心对外通道:
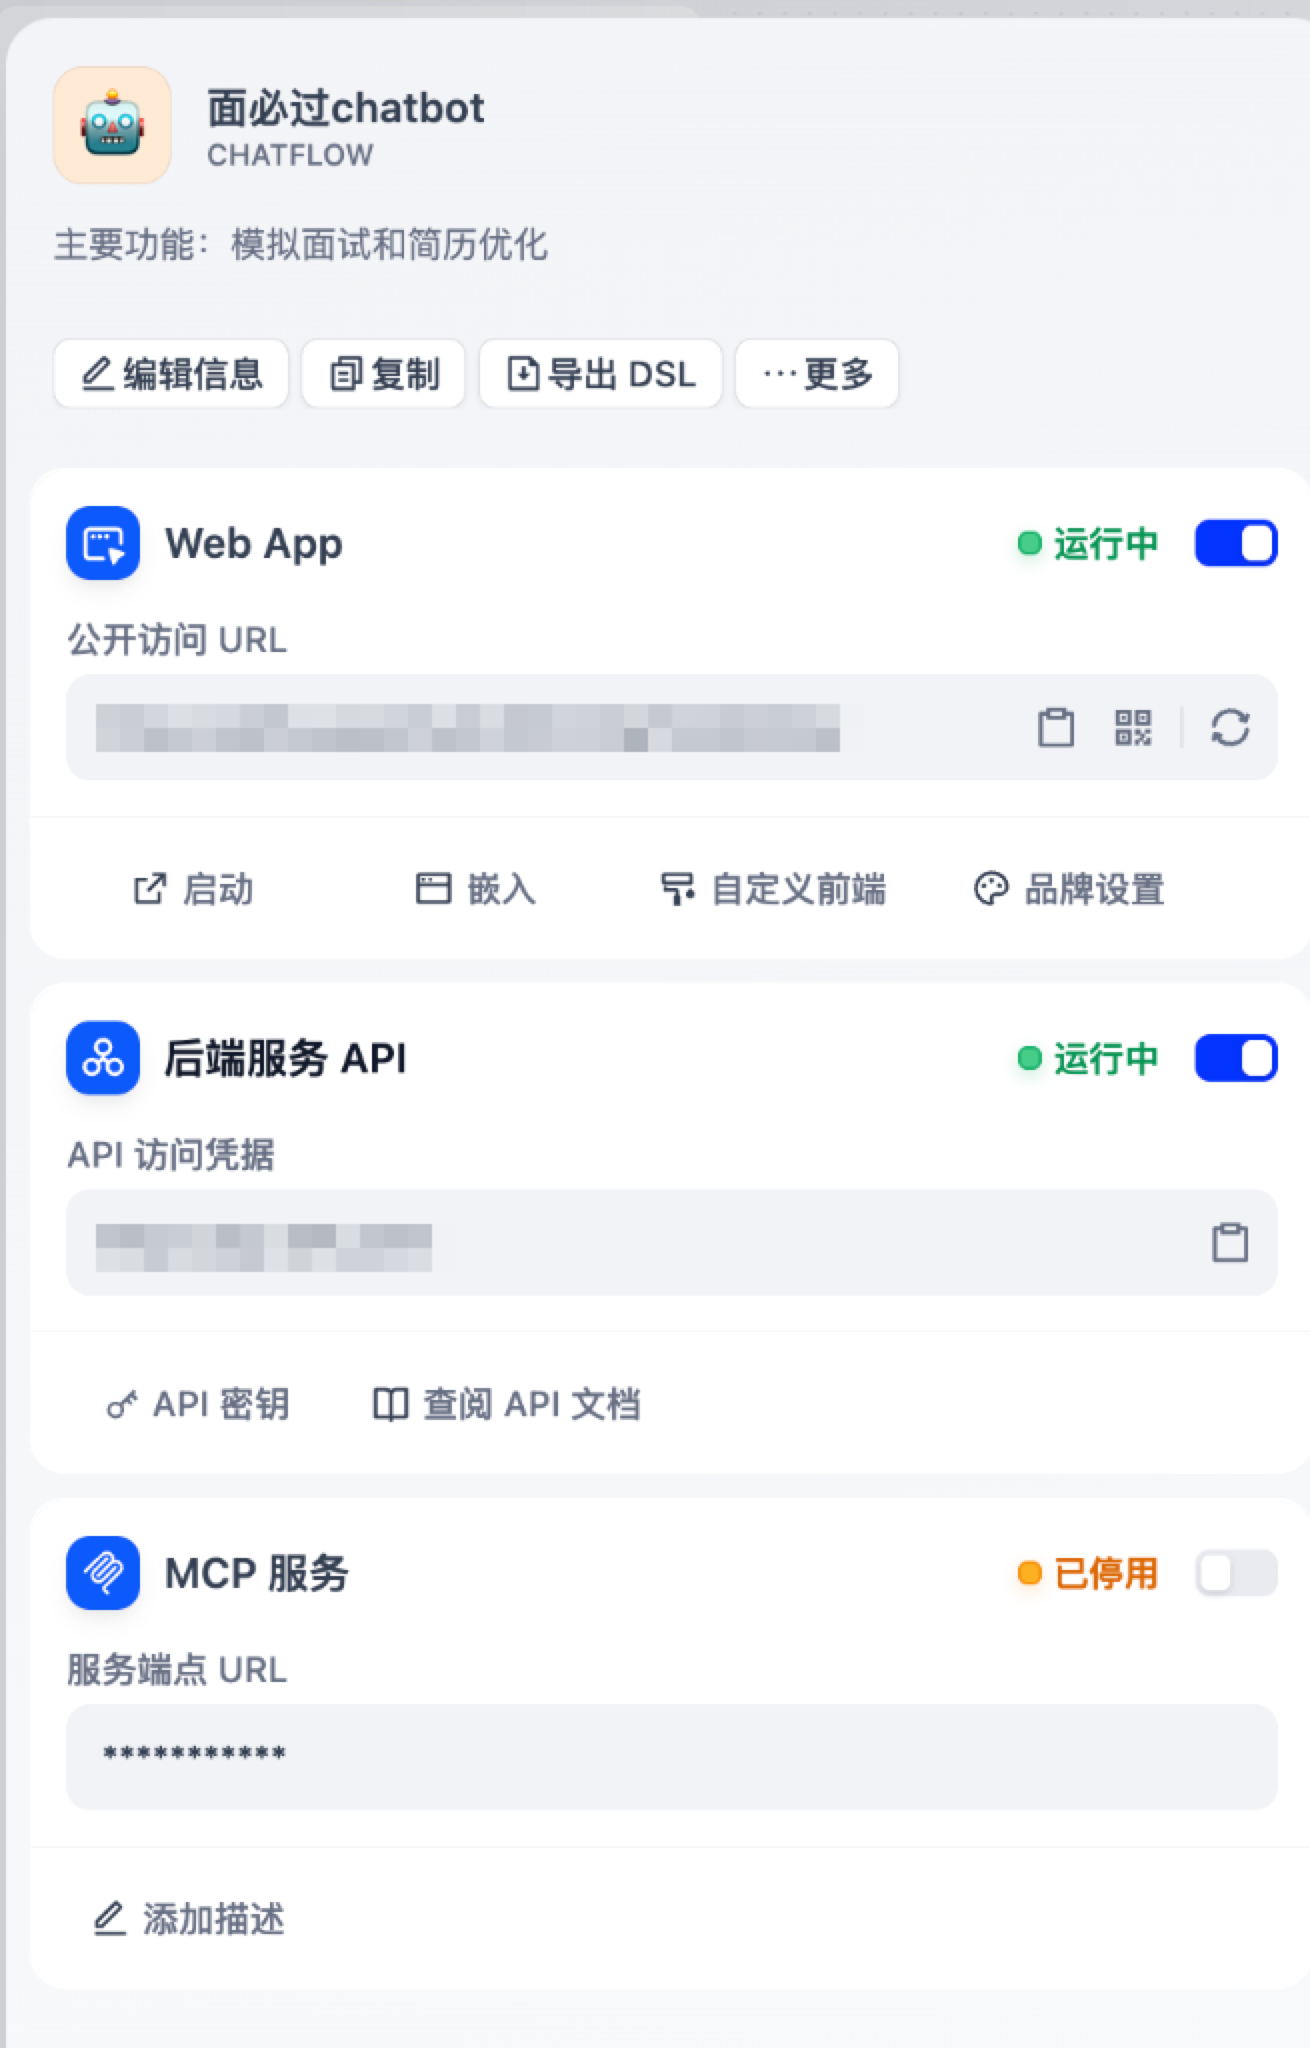

- Web App 独立网页:
- 提供开箱即用的网页聊天界面,支持直接复制公开访问 URL 分享给用户;
- 点击“嵌入”可获取网页 Iframe 或浮窗代码,3 行代码即可将 AI 助手嵌入公司官网或博客。
- 后端服务 API:
- 提供 RESTful API 端点(默认基地址
https://api.dify.ai/v1); - 在“API 密钥”中生成专属的 Bearer Token,即可与企业的自有后端、小程序或 App 打通。
- 提供 RESTful API 端点(默认基地址
- MCP 服务:
- 支持将当前工作流作为标准 MCP 工具向外部智能体开放,让 Claude Code、Cursor 等桌面级 Agent 也能直接调起面试与简历优化能力。
4. Python 后端调用 API 实战代码示例
通过标准 Python requests 库调用 Dify Chatflow 服务的完整代码:
python
import json
import requests

# 1. 配置 Dify API 凭据与端点
DIFY_API_BASE = "https://api.dify.ai/v1"
API_KEY = "app-xxxxxxxxxxxxxxxxxxxxxxxx"  # 在 Dify 控制台生成的 API 密钥

headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}

# 2. 发起对话请求 (以开启模拟面试为例)
payload = {
    "inputs": {
        "jd": "熟练掌握 Python、FastAPI 与大模型工作流编排,具备 Agent 开发经验。"
    },
    "query": "你好,我已上传简历,我想开始模拟面试!",
    "response_mode": "streaming",  # 支持 streaming 流式输出或 blocking 阻塞等待
    "conversation_id": "",         # 首次发起留空,后续轮次传入 Dify 返回的 conversation_id
    "user": "candidate_user_001",
    "files": [
        # 若需要上传文件,可先调用 /files/upload 接口获取 file_id 传入此处
    ]
}

response = requests.post(
    f"{DIFY_API_BASE}/chat-messages",
    headers=headers,
    json=payload,
    stream=True
)

# 3. 处理流式响应并实时打印
print("AI 面试官:", end="", flush=True)
for line in response.iter_lines():
    if line:
        decoded_line = line.decode("utf-8")
        if decoded_line.startswith("data: "):
            try:
                event = json.loads(decoded_line[6:])
                if event.get("event") == "message":
                    print(event.get("answer", ""), end="", flush=True)
                elif event.get("event") == "message_end":
                    print("\n\n[本轮会话结束,已沉淀 Conversation ID:", event.get("conversation_id"), "]")
            except json.JSONDecodeError:
                pass
完整流程黑盒全流程实测展示
为了确保整套应用达到上线标准,我们在独立 Web App 中完成了两条核心业务流的完整完整流程黑盒实测:
实测场景一:沉浸式模拟面试全流程自测

实测场景二:多专家圆桌式简历优化自测

进一步讨论:低代码平台的局限性与实现取舍 —— 为什么我们不用单一 Agent 节点?
在很多低代码平台的宣传演示中,你经常能看到类似这样的设想:“拖入一个万能的 Agent 节点,给它挂上 10 个工具,它就能自主思考、自主规划、自动帮你把面试和简历全搞定。”
但在真实的落地过程中,如果你直接用一个 Agent 节点去承载复杂业务,往往会迅速撞上一堵厚重的工程现实之墙。

1. 为什么不用 Agent 节点?—— 工具调用与数据结构的“阻抗失配”
- 工具返回值与节点预期的契约冲突: Dify 的 Agent 节点内部采用 ReAct / Function Calling 机制运转。当 Agent 自主调用外部插件工具(如
md_to_html或document_extractor)时,工具返回的 payload 结构(可能是字典、文件数组或包含状态码的对象)往往与大模型内部预期的输入格式产生阻抗失配; - 致命后果: 大模型无法准确解析工具返回的数据结构,要么在日志中报错
Tool call failed: Invalid output format,要么误以为工具执行失败而陷入重复调用的死循环; - 无法在网页端拦截: 在云端 SaaS 的图形化界面上,你无法在 Agent 内部插入中间件去拦截并清洗工具的返回值。
2. 跨 LLM 节点的结构化输出类型断层(Schema 适配地狱)
- 后一个 LLM 为什么读不懂前一个 LLM 的 JSON? 理论上,A 节点通过
structured_output生成了 JSON,B 节点直接在 User Prompt 里写{{#A.structured_output#}}就能顺畅使用; - 实际工程中的坑: 由于平台对 JSON Schema 的类型校验严苛,一旦嵌套层级较深,或者模型返回的数值类型与字符串类型稍有偏差,下游节点在取值时就会直接解析失败;
- 排错成本极高: 在网页端开发时,你常常会陷入“改了 A 的 Schema 导致 B 报错,改了 B 又导致 C 解析失败”的反复调参地狱。
3. 本地代码魔改 vs 云端 SaaS 妥协:在 DSL 中多加节点的工程哲学
- 本地私有化部署视角: 如果 Dify 源码部署在自己的服务器上,可以在后端
api/core/workflow/nodes/agent/或工具适配层统一类型转换。实际修改范围应结合当前版本和调用链确认,不能只按固定行数估计; - 云端 Web 网页端视角: 但在使用官方 Cloud 网页版或面对企业标准 SaaS 时,开发者没有修改底层引擎源码的权限。
- 架构师的妥协与破局: 既然无法在平台底层修路,那就在工作流上搭桥。 这就是为什么在我们的「面必过」DSL 中,你看到了看似“繁琐”却无比稳固的防御性节点设计:
- 用确定性工作流替代自由发散的 Agent:通过
状态锁 If-Else + 意图识别,固定主要业务路径,同时保留分类失败时的处理分支; - 显式插入 Python 代码清洗节点:充当数据流的“转接头”与“适配环节”,负责去除
<think>、剥除代码围栏、反转义 HTML 实体; - 串行与并行专家分流:将复杂的单体思考拆解为多个独立 LLM 节点,每个节点背负简单的单一职责与专属 Schema,最终由圆桌会议主持人统一收敛。
- 用确定性工作流替代自由发散的 Agent:通过
显式分支便于检查和复现,也会增加节点维护成本。本例的业务路径比较固定,因此采用工作流;如果任务需要动态选择工具,可以另行评估 Agent 节点。两种方式都需要异常处理和实际验收。
4. 为什么我们需要迈向“代码级 Agent”?
低代码工作流便于直观看到提示词链、数据流转、状态路由和插件调用。需要更灵活的动态分支、复杂循环或深度定制时,再转向 代码级开源 Agent 与开发框架(LangGraph / 手写 Agent) 会更合适。
建立一份可重复运行的验收记录
验收像检查一条公交线路:不能只看车能不能从起点开到终点,还要看中途上下客和异常停车怎样处理。给工作流保留一组固定输入,后续调整节点或更换模型时才能作比较。
| 场景 | 预期结果 | 应保存的证据 |
|---|---|---|
| 无简历开始任务 | 提示补充材料或按约定处理 | 回复内容与实际分支 |
| 面试连续回答三轮 | 问答关联正确 | 会话变量与历史记录 |
| 中途结束后重新开始 | 不沿用上次任务状态 | 前后两次状态值 |
| 导出工具失败 | 给出可理解的提示,保留已有文本 | 报错节点与可用结果 |
| 较长简历 | 完整处理或明确说明限制 | 输入长度与输出完整性 |
记录应用版本、模型配置、用例结果和失败节点即可,不需要保存未经脱敏的真实简历。一次运行成功可以记作通过,但不能据此承诺所有输入都稳定。
发布前把当前 DSL 导出保存,并用发布入口再跑一遍关键路径,确认正在访问的是本次版本。若出现回退需求,还要检查模型和插件配置是否仍兼容旧 DSL。
通过接口接入时,应用密钥应留在自己的后端,由后端转发请求。对话请求还应正确保存并传回服务返回的会话标识,避免每次请求都开启新对话,导致状态看似“丢失”。
发布后再跑一遍同组用例
画布调试通过,只能说明草稿环境中的节点能运行。正式发布后,访问入口、凭据权限、插件可用性和会话标识都可能不同,因此应使用与调试阶段相同的输入再验收一次,并把结果分开记录。
| 发布后的检查 | 关注点 |
|---|---|
| Web App 新会话 | 初始变量是否为空,上传与下载是否可用 |
| 连续多轮会话 | 会话标识是否稳定,上一轮状态是否正确延续 |
| API 调用 | 输入字段、鉴权、超时和错误响应是否符合约定 |
| 外部插件失败 | 用户是否得到可理解的提示,流程能否安全结束 |
发布前应记录当前可用版本和回退方式,例如保留上一份 DSL、插件版本和关键配置截图。若线上结果异常,先确认是发布配置还是流程逻辑,再决定回退或修复。涉及模型更换时,除了能否执行,还要比较固定用例的事实准确性和输出结构,避免接口仍然成功但内容已经偏离预期。
本节回顾
保留固定用例和版本记录,可以让调试结果用于后续比较。发布入口、文件下载和外部接口,都应在最终使用环境中重新验证。

第五章预告:迈入代码级智能体开发
至此,第四章已经完成从节点编排到发布验收的完整练习。
低代码工作流让我们以最直观的可视化方式理解了大模型应用的拓扑结构与数据流转;而在接下来的 第五章:OpenCode 实战 中,我们将把视野投向更加自由、灵活的 代码级开源 Agent 与本地模型协同开发,开始直接操作项目文件。在这之前可以做好以下准备: 下一章先安装 OpenCode 并接通模型;做到博客项目时,再按说明准备 Python 环境。