主题
6.4 评论、点赞与分页改造
评论、点赞和分页看起来都是小功能,却会同时影响数据表、接口和页面。本节沿着一次读者互动的过程,说明怎样防止重复点赞、怎样展示评论,以及列表改成分页后需要一起调整哪些地方。
社交互动与性能分页
在进入社交与分页重构前,我们通过日常生活中的通俗场景理解三大核心机制:

- 👍 重复点赞控制(唯一约束 + 幂等):数据库对
(post_id, user_id)建立唯一约束,避免同一用户对同一文章产生多条点赞记录。它能处理重复点击,不能单独防止批量账号刷量; - 💬 楼层评论(一对多关联):就像是摩天大楼的房号登记表。评论按发布时间先来后到严谨排序,最早留言的是
1楼,后续依次递增。评论作者本人或管理员有权删楼,其他用户严禁越权删除; - 📑 接口分页重构(Page & PageSize):就像是餐厅的翻页菜单。如果把一千道菜一口气打印在十米长的纸卷上直接塞给顾客,不仅客人眼花缭乱,后厨也会瞬间崩溃。分页将文章按每页 9 篇结构化返回,并附带总数与页码元信息,大幅减轻数据库压力与网络开销。
开启 Trae Solo 模式:连续执行任务
在第一阶段,我们体验了 Plan 模式下与 AI 一问一答的交互确认;而在本阶段,我们要体验更加的“完整流程全自动交付”。
1. 切换至 Solo 模式
在 Trae 顶部或 Agent 面板切换为 SOLO 模式:
💡 原理解析:Solo 模式类似于 OpenAI Codex 的 Goal 模式。开启后,智能体不再每走一步都停下来等待人类确认,而是获得了完整的自主推进权限——它会自省、自测、自动调用终端命令并自动修复报错,直到把最终任务完整交付。
2. 派发宏观需求说明
在 Solo 模式输入框中输入以下指令并敲下回车:
实现阶段二实战:评论与点赞社交系统 + 接口分页重构

先列计划到docs/下,然后按规范就行开发和验收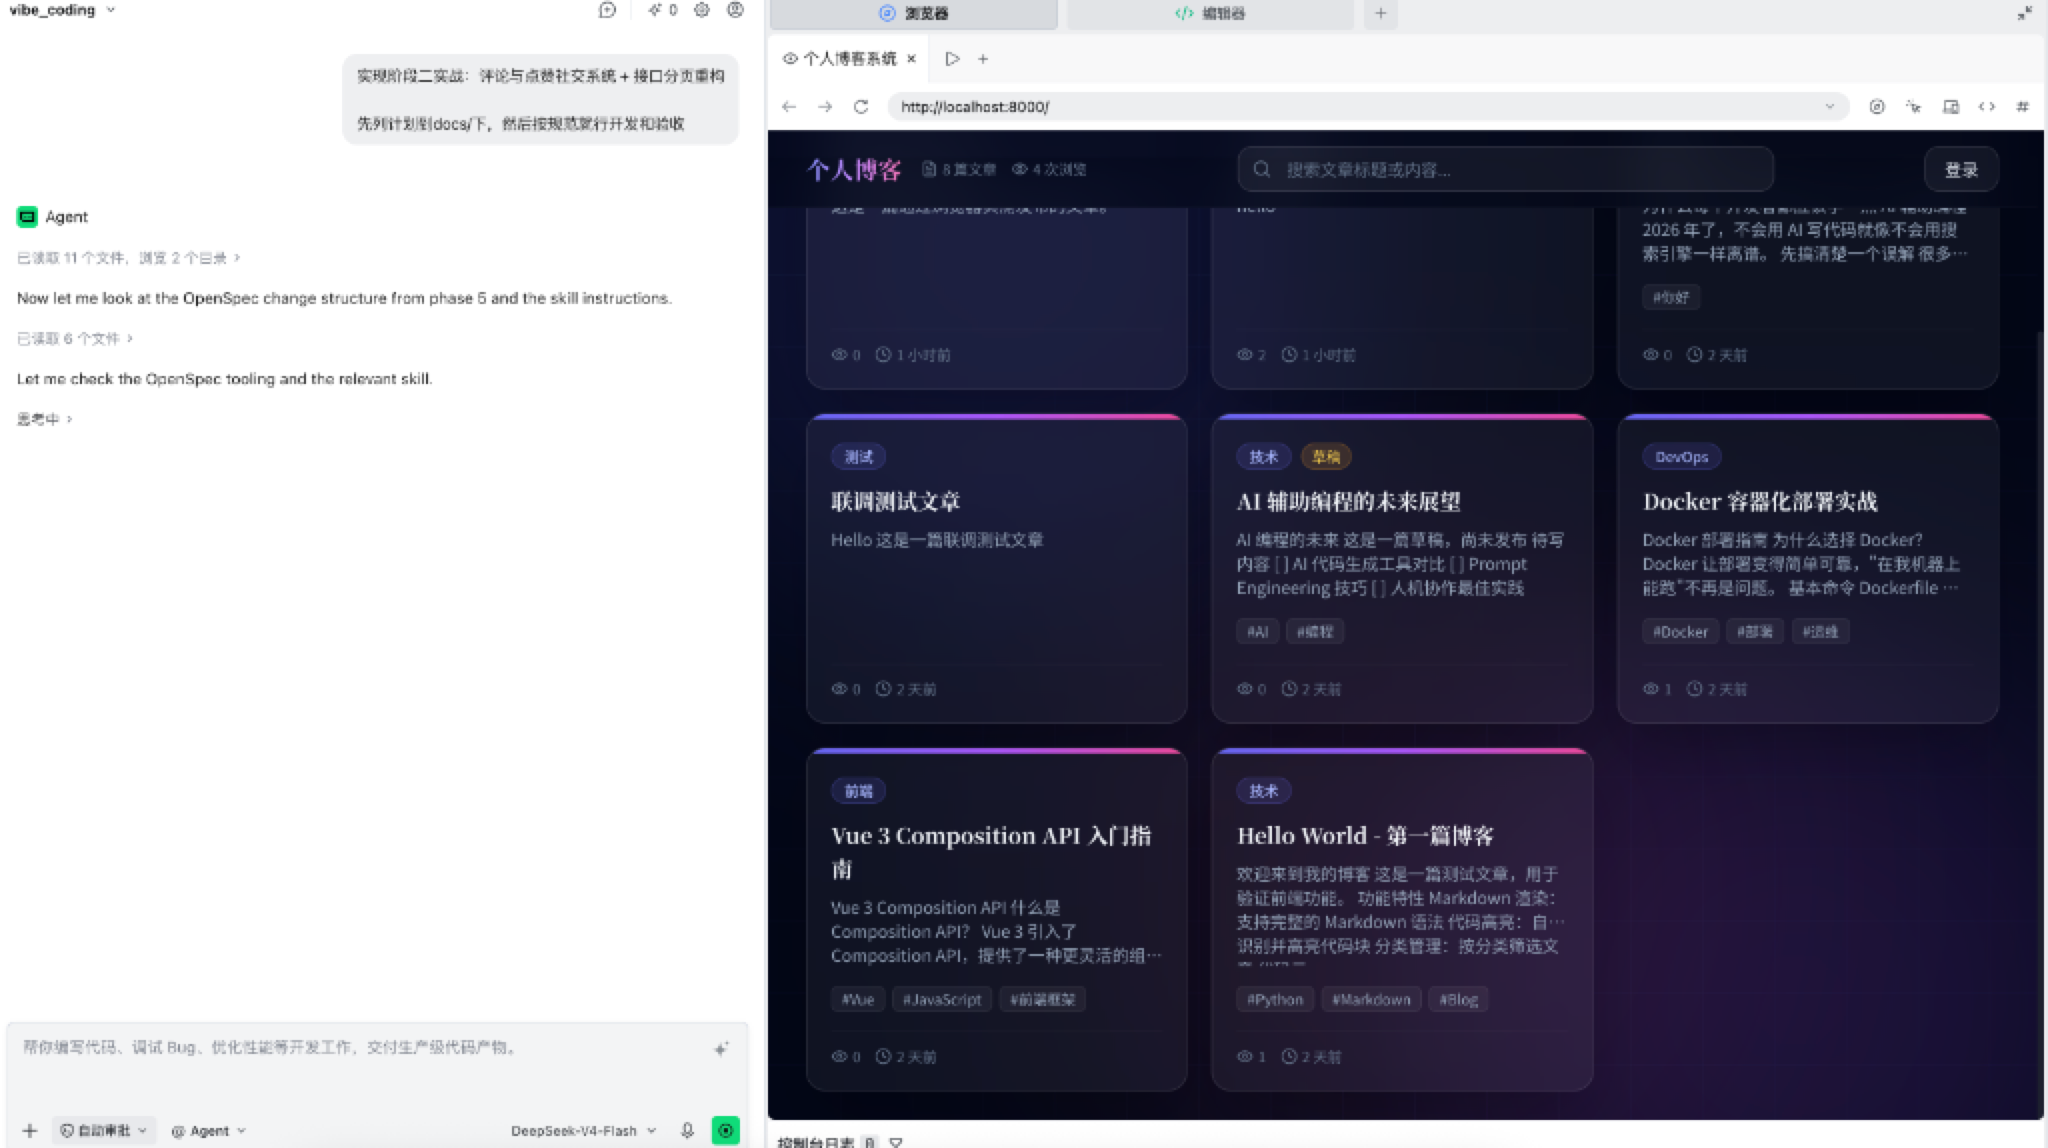
3. 规范规划与基线自动验证
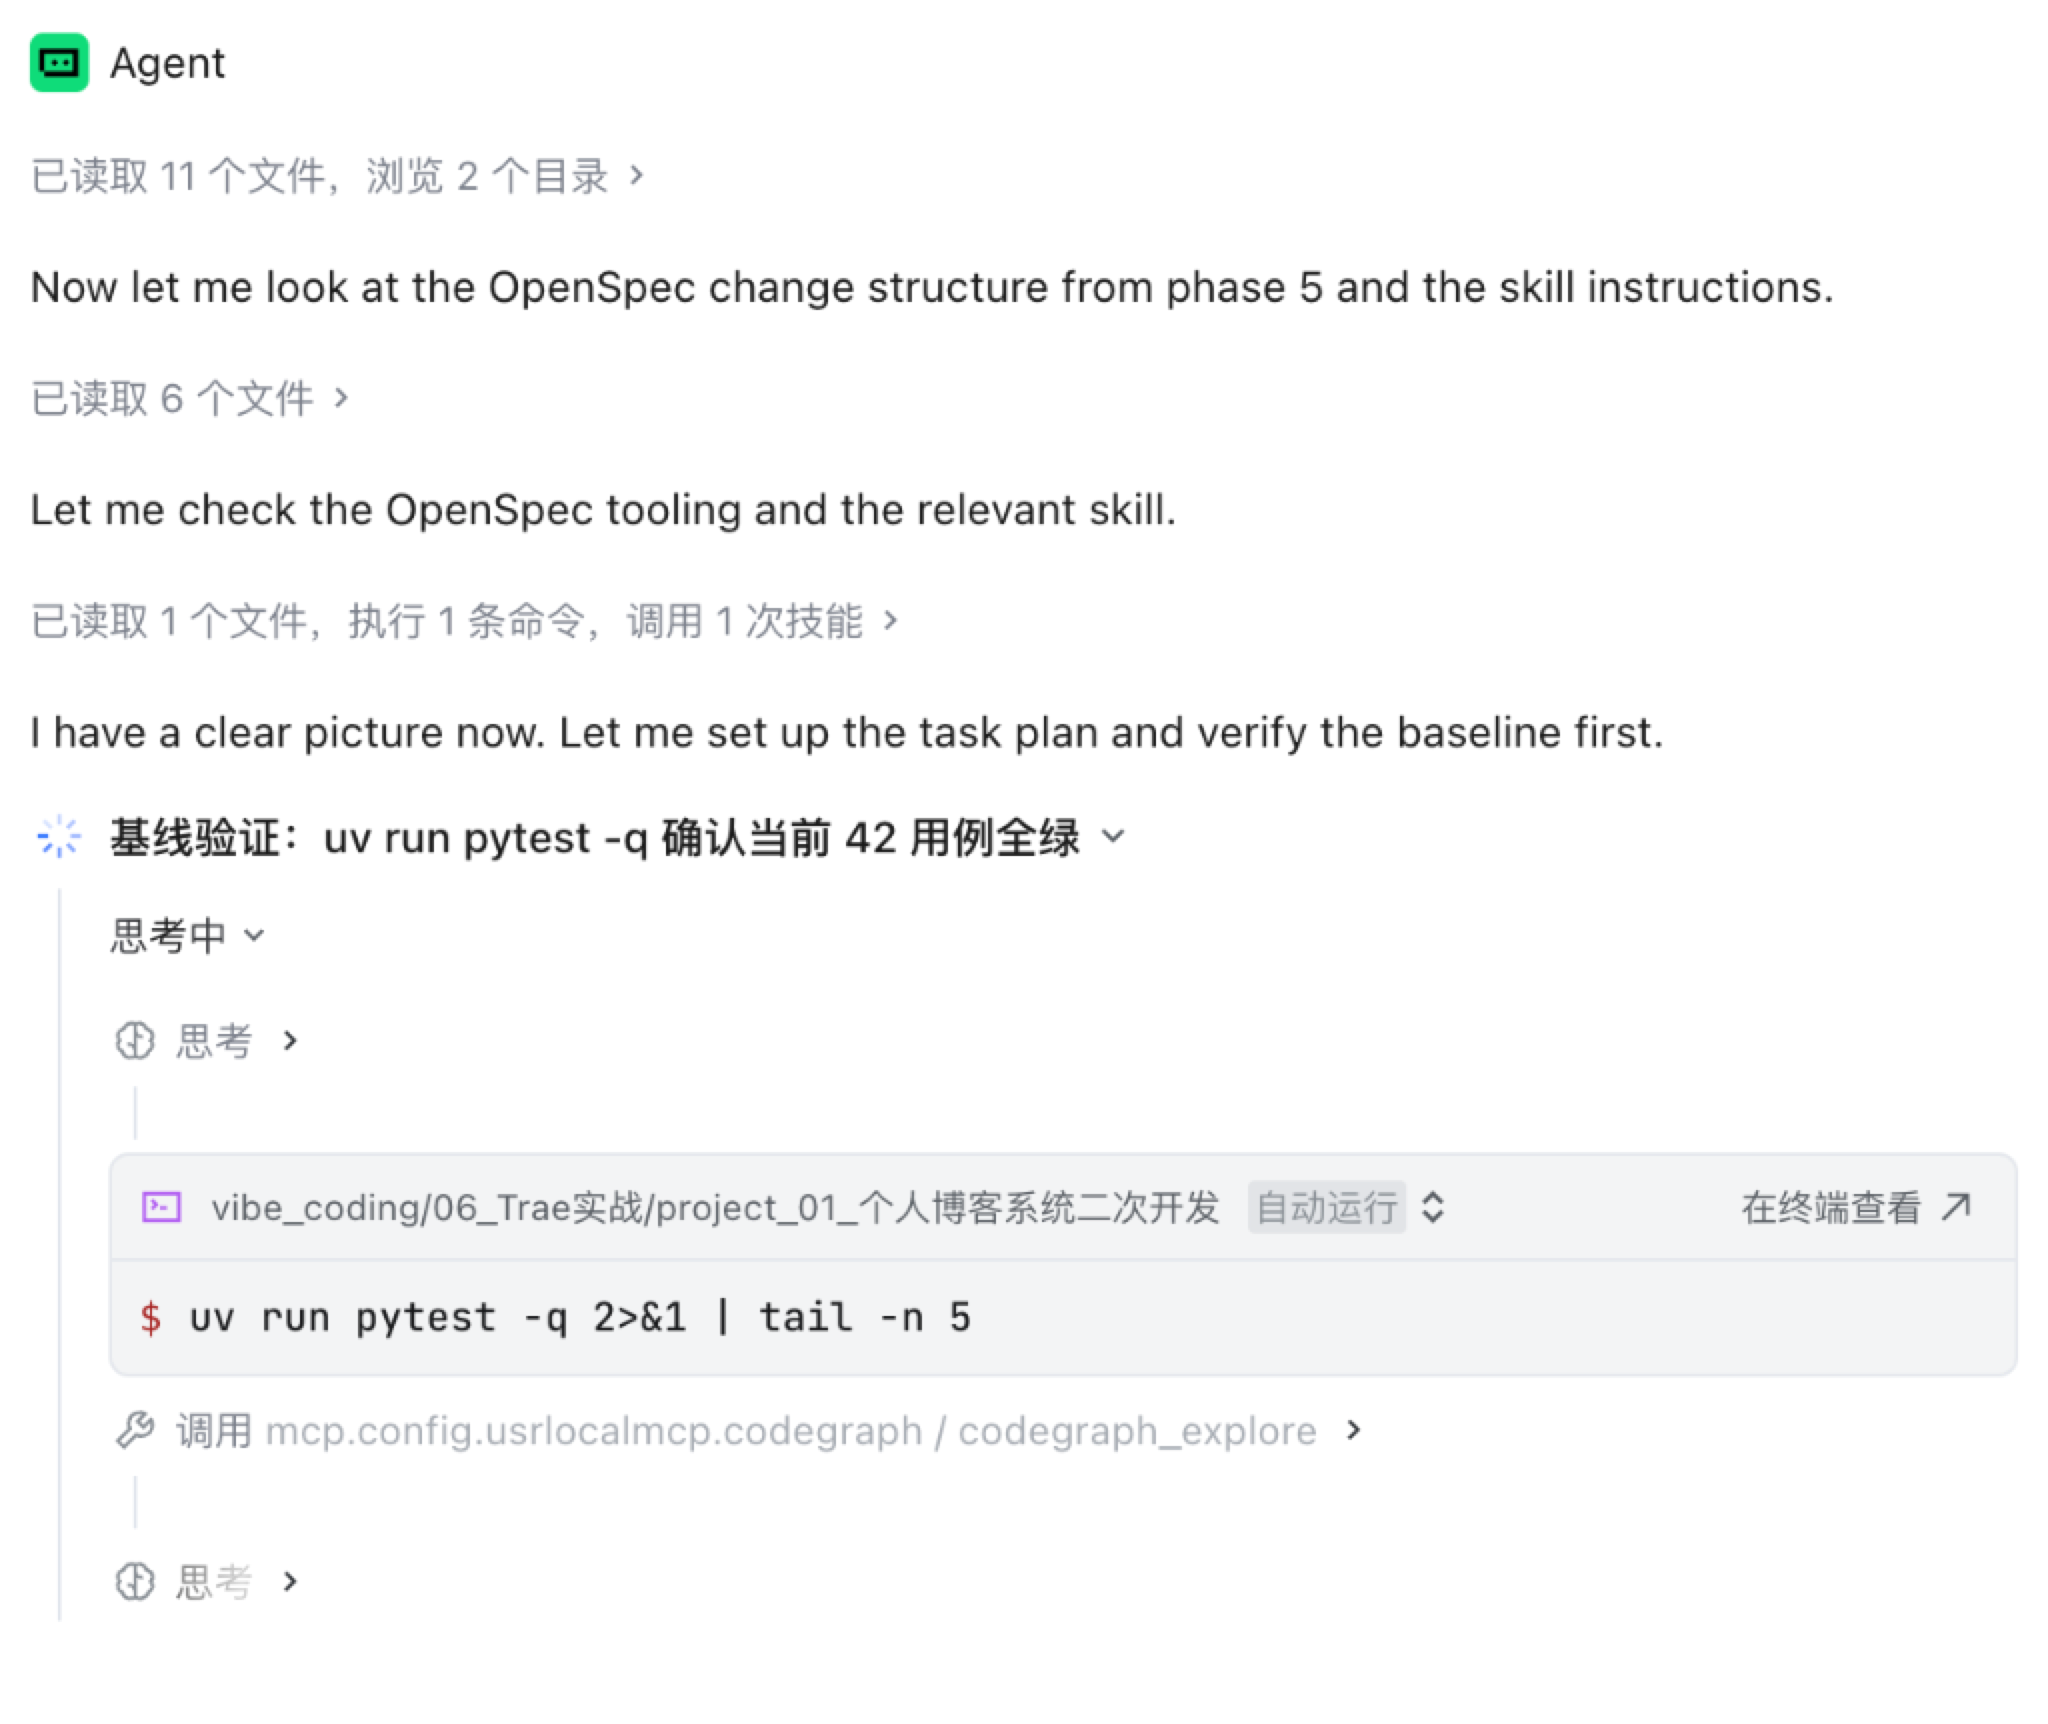
Agent 接收到指令后,会立刻展开以下自主动作(如下图所示):
- 自动调用
OpenSpec规格工具与技能包,深度阅读既有代码与阶段规范; - 自动在终端执行
uv run pytest -q,确认当前系统 42 个用例全部处于健康绿灯状态; - 自动调用 CodeGraph MCP(
codegraph_explore)扫描项目调用拓扑图谱; - 自动在
docs/目录下生成完整的实施蓝图:docs/phase06_评论点赞系统与接口分页重构.md。
自主推进中的实战细节与高效体验
任务开始后,可以通过执行记录查看正在改哪些文件、运行哪些检查。遇到错误时,先确认它是否找到原因,而不是只看任务是否继续推进。
1. 探索 Agent 的“思考链路”
感兴趣的同学可以点击面板上的 「思考中 >」 展开折叠菜单。在这里你可以清晰地看到大模型的内部思维链:
- 它是如何权衡分页数据结构的破坏性影响;
- 它是如何设计
IN + GROUP BY批量查询来规避 N+1 性能陷阱; - 它是如何遵循 ATDD 规则,先改写测试使其变红、再编写业务代码让测试变绿。
2. 常见现象处理:模型思考次数达上限(点击「继续」)
在复杂任务的长链路推进过程中,有时面板上会弹出一条黄色提示:
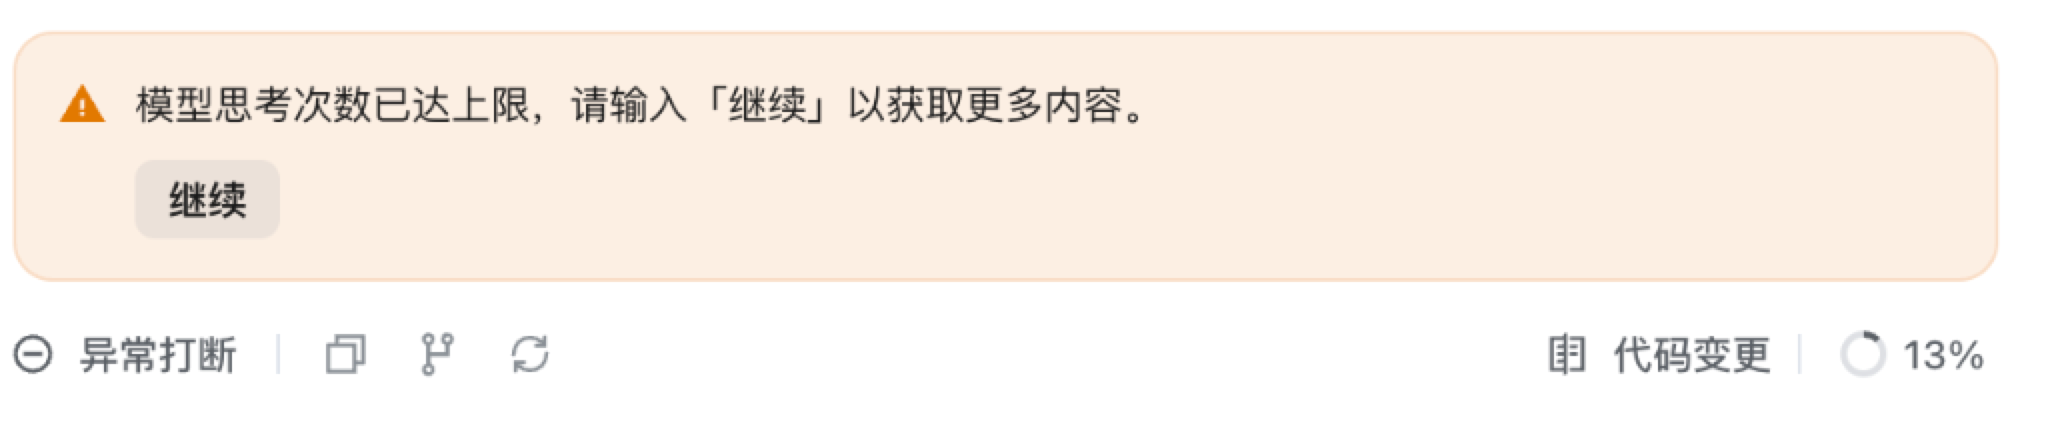
💡 官方机制解析:在同一段对话中,大模型推理轮次有预设的安全限制。当任务较为庞大、多文件改动较多时,为了避免模型产生幻觉导致死循环与 Token 无效浪费,系统会自动触发阶段性熔断机制。
👉 应对方法:遇到该提示完全不用慌张,直接点击按钮中的 「继续」 即可。Agent 会自动承接上一轮的上下文断点,继续推进后续任务。
3. 内置浏览器实时全自动验收
在等待 Agent 完成的过程中,我们可以实时观察右侧 Trae 内置浏览器 的运行情况:
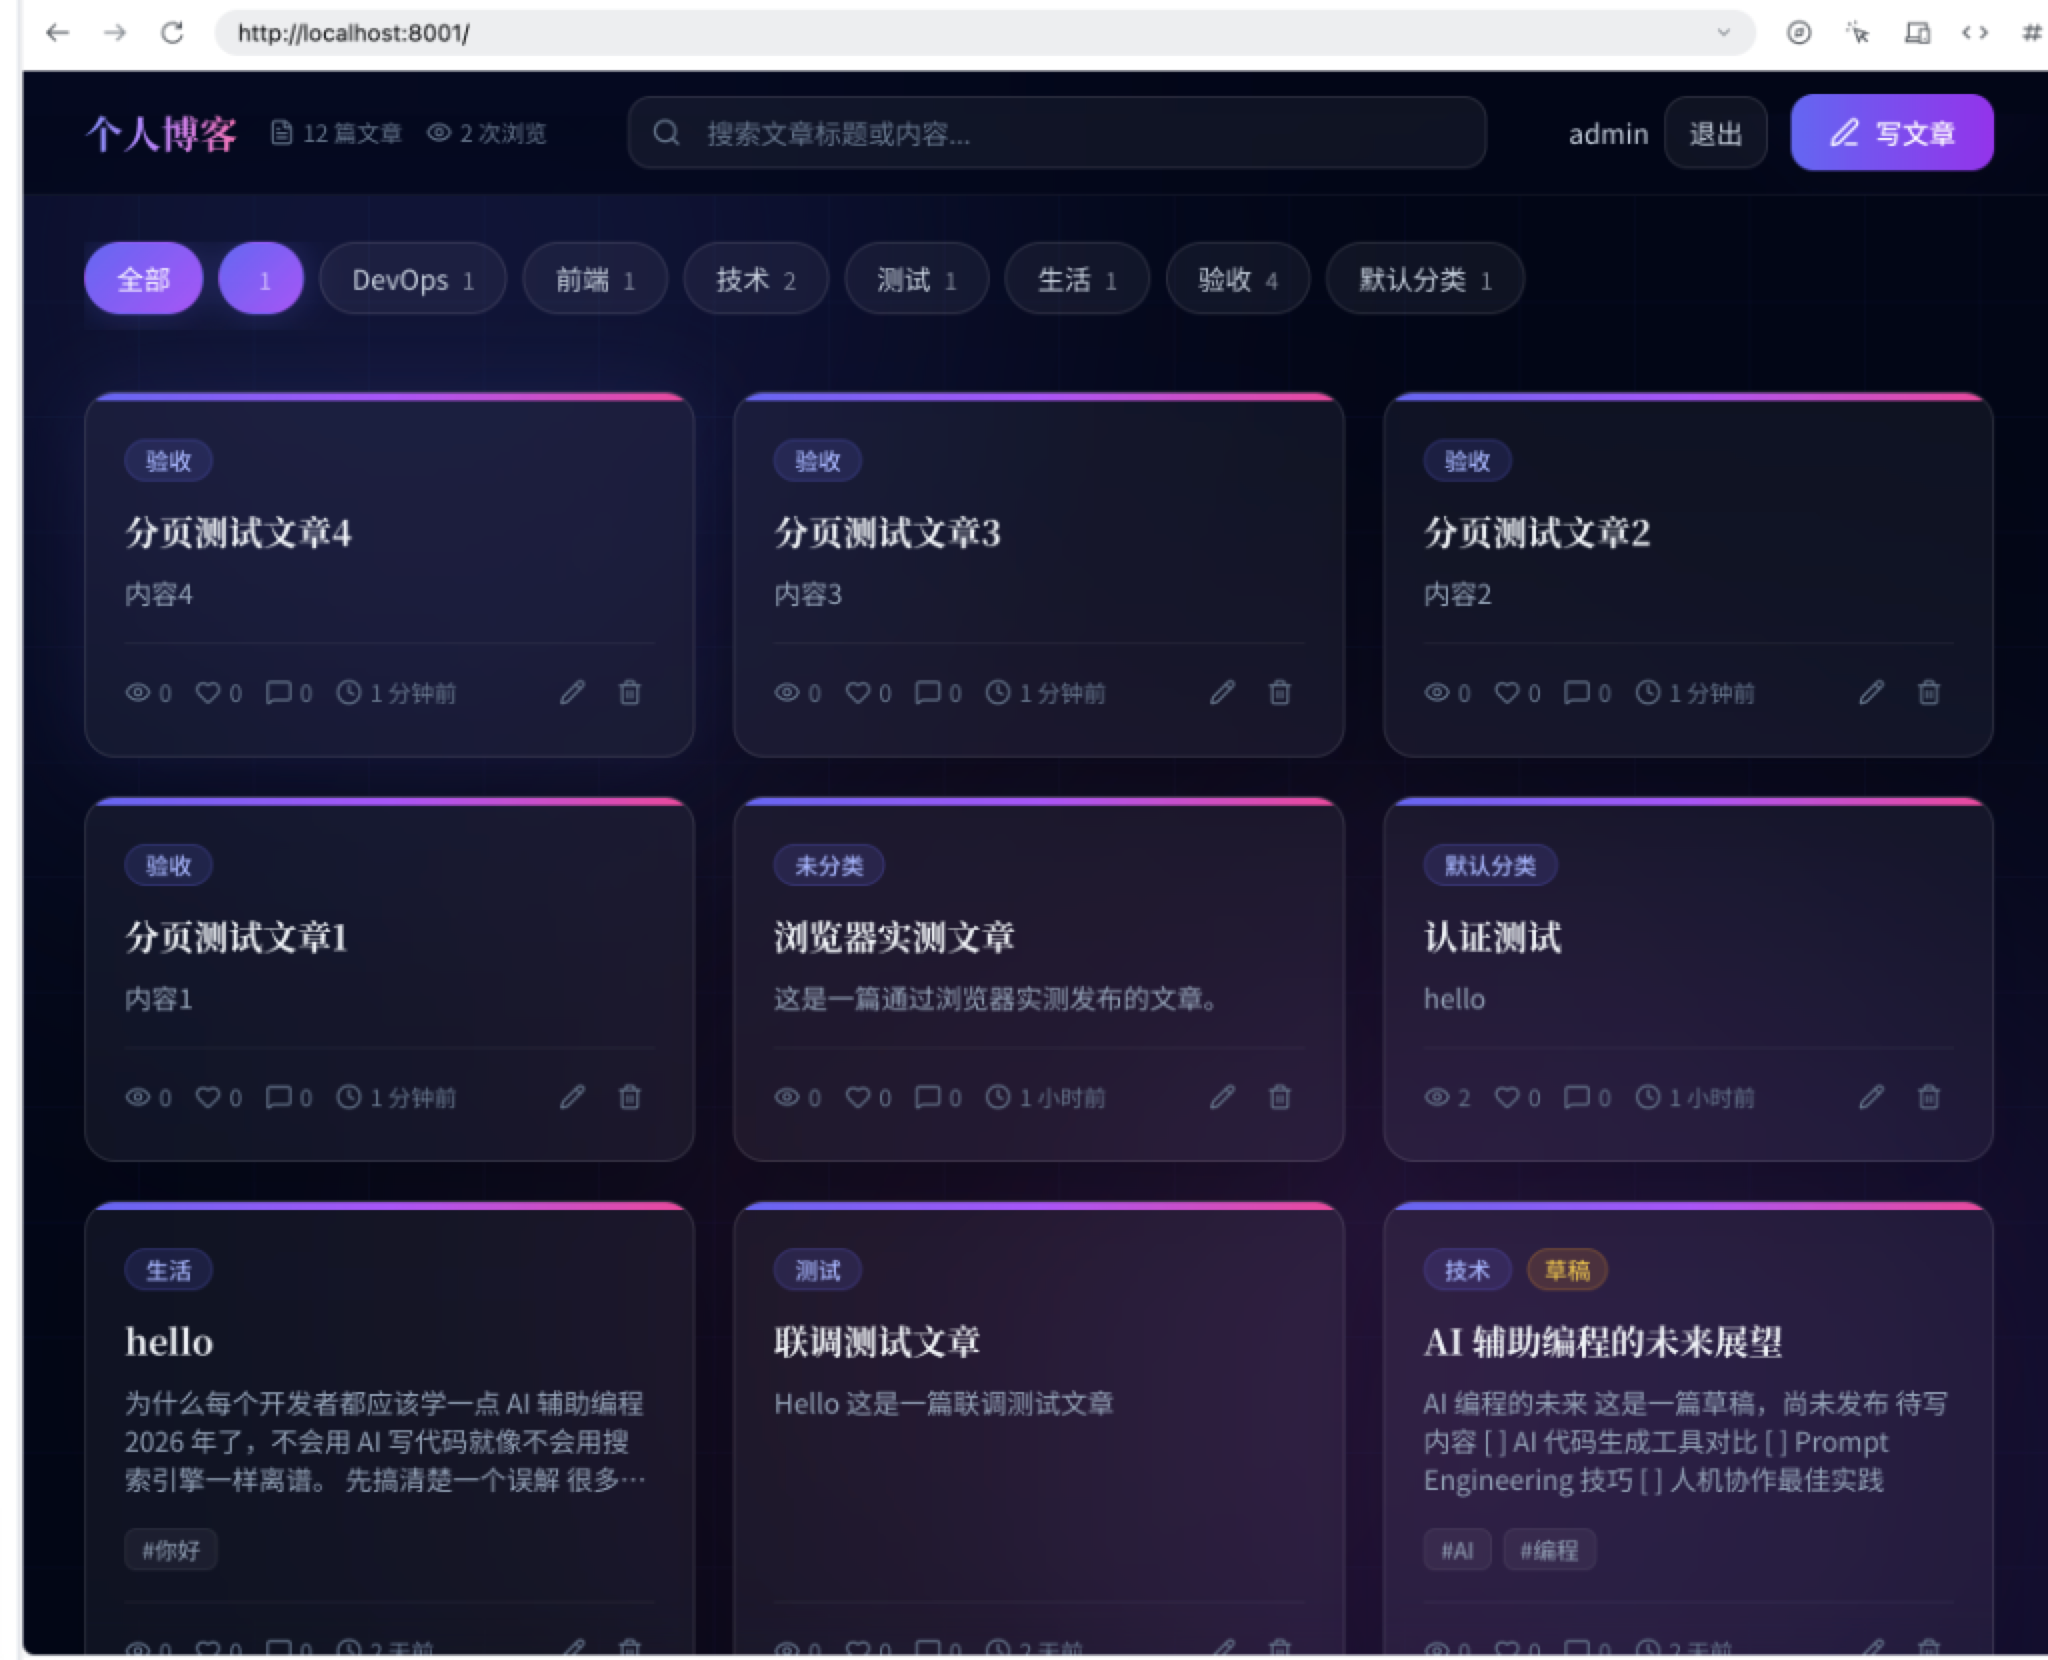
你会发现 AI 在不需要人类操控鼠标键盘的情况下,全自动在浏览器中执行了一系列实际的完整流程验收:
- 自动在浏览器中创建测试文章(如
分页测试文章1~分页测试文章4); - 自动点击分页控件进行翻页与分类筛选;
- 自动登录
admin账号并点开文章详情; - 自动执行点赞交互与发布评论测试。
浏览器自动化可以重复执行固定操作,适合检查页面流程。开发者仍需确认用例是否覆盖需求、测试数据是否被清理,以及自动化结果与实际接口行为是否一致。
核心架构与落地代码说明
在阶段二中,Agent 为博客系统注入了强大的社交与分页能力,整体架构依然遵循清晰的分层规范:
1. ORM 模型层:models.py(新增 Comment 与 Like 表)
python
from sqlalchemy import ForeignKey, Integer, String, Text, UniqueConstraint

# 评论表:一对多关联文章与用户
class Comment(Base):
    __tablename__ = "comments"

    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True)
    post_id: Mapped[int] = mapped_column(Integer, ForeignKey("posts.id"), nullable=False, index=True)
    user_id: Mapped[int] = mapped_column(Integer, ForeignKey("users.id"), nullable=False, index=True)
    content: Mapped[str] = mapped_column(Text, nullable=False)
    created_at: Mapped[datetime] = mapped_column(default=datetime.now)

# 点赞表:唯一约束防刷
class Like(Base):
    __tablename__ = "likes"

    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True)
    post_id: Mapped[int] = mapped_column(Integer, ForeignKey("posts.id"), nullable=False, index=True)
    user_id: Mapped[int] = mapped_column(Integer, ForeignKey("users.id"), nullable=False, index=True)
    created_at: Mapped[datetime] = mapped_column(default=datetime.now)

    __table_args__ = (
        UniqueConstraint("post_id", "user_id", name="uq_like_post_user"),  # 数据库级防刷保证
    )
2. 认证中枢扩展:security.py(新增可选登录依赖)
为了让公开的博客列表与详情页能够展示“当前用户是否已点赞”,同时又不破坏“未登录用户也能正常浏览”的原则,新增了 get_optional_user:
python
oauth2_scheme_optional = OAuth2PasswordBearer(tokenUrl="/api/auth/login", auto_error=False)

def get_optional_user(
    token: str | None = Depends(oauth2_scheme_optional),
    db: Session = Depends(database.get_db),
) -> User | None:
    """可选登录守卫:有有效 Token 返回 User 对象,无 Token 返回 None(不抛 401 异常)"""
    if not token:
        return None
    try:
        payload = jwt.decode(token, SECRET_KEY, algorithms=[ALGORITHM])
        user_id = int(payload.get("sub"))
    except (jwt.PyJWTError, TypeError, ValueError):
        return None
    return db.query(User).filter(User.id == user_id).first()
3. 数据契约层:schemas.py(分页与社交 DTO)
python
# PostResponse 扩展点赞数、评论数与当前用户点赞态
class PostResponse(BaseModel):
    id: int
    title: str
    content: str
    category: str
    tags: str
    status: str
    views: int
    likes: int = 0             # 点赞总数
    comment_count: int = 0     # 评论总数
    liked: bool = False        # 当前访问者是否已点赞
    created_at: datetime
    updated_at: datetime
    model_config = {"from_attributes": True}

# 文章分页包装模型
class PaginatedPosts(BaseModel):
    items: list[PostResponse]
    total: int
    page: int
    page_size: int

# 评论返回模型(含楼层用户名)
class CommentResponse(BaseModel):
    id: int
    post_id: int
    user_id: int
    username: str
    content: str
    created_at: datetime

# 点赞响应模型
class LikeResponse(BaseModel):
    liked: bool
    likes: int
4. 业务与路由层:main.py(批量统计与接口重构)
针对列表查询可能引发的 N+1 性能问题,通过 SQL GROUP BY 进行批量聚合统计,单次查询搞定全部社交计数:
python
def _post_counts(db: Session, post_ids: list[int]) -> dict[int, dict[str, int]]:
    """批量高效统计文章的点赞数与评论数(告别 N+1 查询)"""
    if not post_ids:
        return {}
    likes_q = db.query(Like.post_id, func.count(Like.id)).filter(Like.post_id.in_(post_ids)).group_by(Like.post_id).all()
    comments_q = db.query(Comment.post_id, func.count(Comment.id)).filter(Comment.post_id.in_(post_ids)).group_by(Comment.post_id).all()
    counts = {pid: {"likes": 0, "comments": 0} for pid in post_ids}
    for pid, count in likes_q: counts[pid]["likes"] = count
    for pid, count in comments_q: counts[pid]["comments"] = count
    return counts

# 分页文章列表接口(返回 PaginatedPosts)
@app.get("/api/posts", response_model=PaginatedPosts)
def get_posts(
    page: int = Query(1, ge=1),
    page_size: int = Query(9, ge=1, le=50),
    category: str | None = Query(None),
    status: str | None = Query(None),
    search: str | None = Query(None),
    db: Session = Depends(database.get_db),
    current_user: User | None = Depends(security.get_optional_user),
):
    query = db.query(Post)
    if category: query = query.filter(Post.category == category)
    if status: query = query.filter(Post.status == status)
    if search: query = query.filter(Post.title.contains(search) | Post.content.contains(search))

    total = query.count()
    posts = query.order_by(Post.created_at.desc()).offset((page - 1) * page_size).limit(page_size).all()

    counts = _post_counts(db, [p.id for p in posts])
    liked_ids = _liked_post_ids(db, current_user)
    items = [_post_response(p, counts, liked_ids) for p in posts]
    return PaginatedPosts(items=items, total=total, page=page, page_size=page_size)
5. 前端社交与分页集成:index.html
- 首页分页条控件:卡片网格底部自动渲染页码组件(上一页、当前页/总页数、下一页),切换分类或搜索自动重置到第 1 页;
- 卡片社交徽标:每张文章卡片底部直观呈现阅读量
👁、点赞数🤍与评论数💬; - 阅读器交互闭环:
- 文章详情顶部提供高亮心形点赞按钮,支持一键点赞/取消点赞;
- 详情底部渲染楼层评论区(如
1楼、2楼),展示评论者用户名、相对时间及删除按钮(仅作者本人与管理员可见); - 全站对用户输入内容一律采用
escapeHtml严密防范 XSS 注入攻击。
进阶原理说明(面试高频考点)
1. 三种主流分页方案横向对比(Offset vs Cursor vs Keyset)
| 方案 | 实现方式 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| Offset 分页(本教程采用) | LIMIT page_size OFFSET (page-1)*page_size + 统计 total | 实现最简单、支持“跳页”,能显示总页数 | 数据量大时翻越深越慢;期间数据变动会出现重复/遗漏 | 中小规模数据(本博客完全够用) |
| Cursor 分页 | 携带上一页最后一条记录的 ID/时间戳,WHERE id < cursor LIMIT n | 深层翻页恒定快、数据稳定不漂移 | 实现复杂、无法直接跳页,需要维护游标 | 海量数据 + 无限滚动(朋友圈/微博流) |
| Keyset 分页 | 基于唯一有序键(如 created_at, id)做范围查询 | 索引利用好、性能优秀 | 同样不支持跳页、排序键必须唯一 | 高并发大表列表流 |
🧠 一句话决策:项目小、要翻页控件 → Offset;体量大、要无限流 → Cursor/Keyset。我们的博客选择了 Offset + 参数化分页,并严格遵守
{items,total,page,page_size}契约,便于未来平滑升级。
2. “N+1 查询”是什么?为什么 IN + GROUP BY 能根治它?
假设首页展示 9 篇文章,如果按“新手直觉”写:
python
for post in posts:                     # 1 次查询取 9 篇文章
    post.like_count = db.query(...).filter(post_id=post.id).count()   # 每篇再查 1 次点赞
    post.comment_count = db.query(...).filter(post_id=post.id).count() # 每篇再查 1 次评论
总共执行 1 + 9×2 = 19 次数据库查询——这就是著名的 N+1 问题(1 次主查询 + N 次子查询)。当文章涨到 100 篇/页时,就是 201 次查询,数据库直接被拖垮。
而 _post_counts 用 一次 IN 过滤 + 一次 GROUP BY 聚合 就能同时拿到 9 篇文章的全部点赞数/评论数:
python
db.query(Like.post_id, func.count(Like.id))
  .filter(Like.post_id.in_(post_ids))   # 一次把所有文章的点赞一次性捞出
  .group_by(Like.post_id)               # 再按文章 ID 分组计数
不管文章有多少篇,始终只要 2 次查询(点赞 1 次 + 评论 1 次)。复杂度从 O(N) 骤降到 O(1),这就是“批量聚合统计”的威力。
3. 点赞为什么“狂按不叠加”?—— 唯一约束 + 幂等设计的本质
数据库层面用 UniqueConstraint("post_id", "user_id") 建立了复合唯一约束,从根上保证“同一用户对同一文章只能有一条点赞记录”:
- 第一次点赞:往
likes表插入(post_id=1, user_id=1)→ 成功,点赞数 +1; - 疯狂再点:再次插入
(post_id=1, user_id=1)→ 违反唯一约束,数据库直接报错,业务层捕获后按“已点赞”幂等处理(或走取消点赞分支)→ 点赞数纹丝不动; - 再点取消:删除该行 → 点赞数 -1。
💡 相比“老土写法”
post.likes += 1(在文章表上放一个整数字段无脑累加),唯一约束方案天然免疫并发刷量:即使 100 个请求同时打过来,数据库也只允许一条记录存在。这正是红线清单第 11 条的精神——点赞必须基于唯一约束幂等实现,严禁无约束累加。
4. 为什么删文章要“级联删除”相关评论与点赞?
当文章被删除时,如果它的评论和点赞记录还残留在 comments / likes 表中,就会产生孤儿数据(数据库里躺着永远没人引用的死数据)。因此删除文章时,必须一并删除其关联的评论与点赞(cascade 级联 或 业务层先删子表再删主表),保持数据一致性。面试时常考的问题“删除主表数据时如何同步清理子表”就对应这个点。
5. XSS 注入:为什么评论内容必须 escapeHtml?
如果直接把用户输入的评论原样塞进 HTML,攻击者可以提交:
html
<script>alert('你的 Cookie 被盗了')</script>浏览器执行后就能窃取用户登录态(Cookie / localStorage 里的 Token)。escapeHtml 的本质是把 <、>、"、'、& 等特殊字符转义成 HTML 实体(如 < → <),让浏览器把它当作纯文本展示而不是可执行代码:
- ✅
<script>alert(...)</script>—— 只显示文本,绝不当代码执行; - 🚫 直接拼接原始输入 —— 被注入,用户数据被盗。
输入处理原则:外部输入必须经过校验和安全输出。前端展示时正确转义,后端用 Pydantic 校验字段,数据库查询采用参数化方式;同时根据内容类型和使用位置决定具体处理方法。
全流程自主验收成果与实测展示
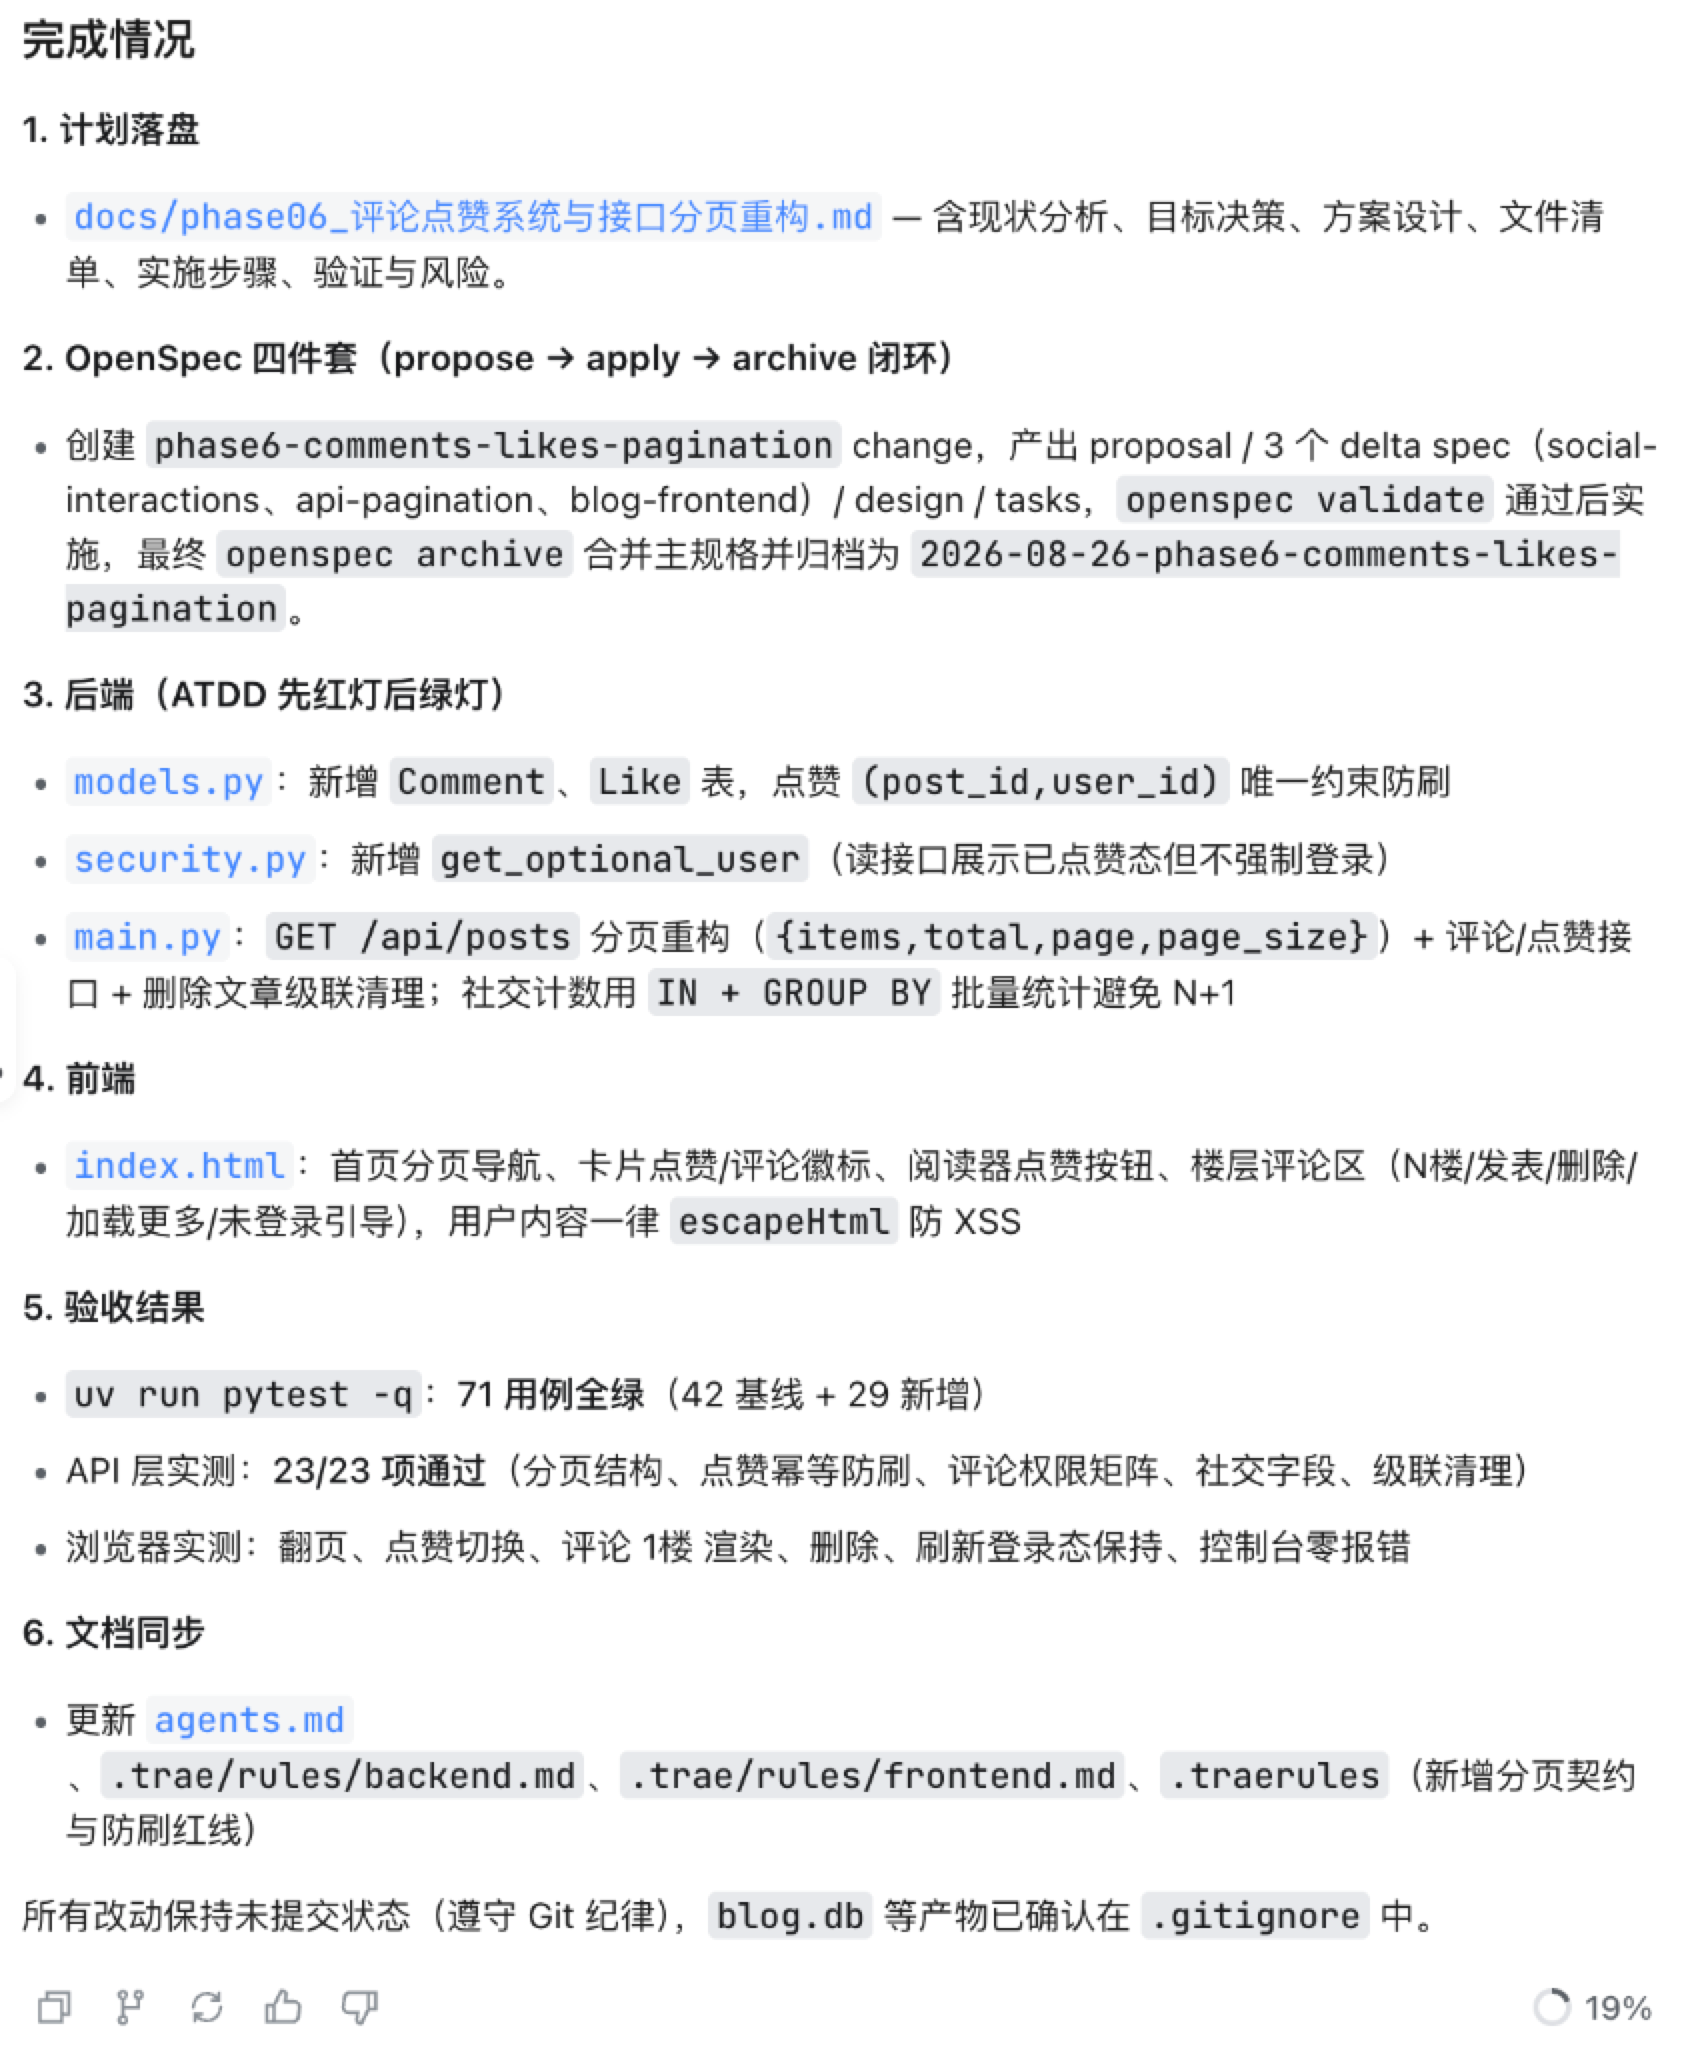
案例中的任务完成后,工具输出了执行与验收记录,下面是当时的截图:
1. Agent 阶段完成看板汇总
Agent 自动完成实施蓝图保存、OpenSpec 规格归档、71 个 pytest 用例全部绿灯通过(42 基线 + 29 新增)、23 项 API 契约实测全通,并同步更新了 agents.md 与规则文件:
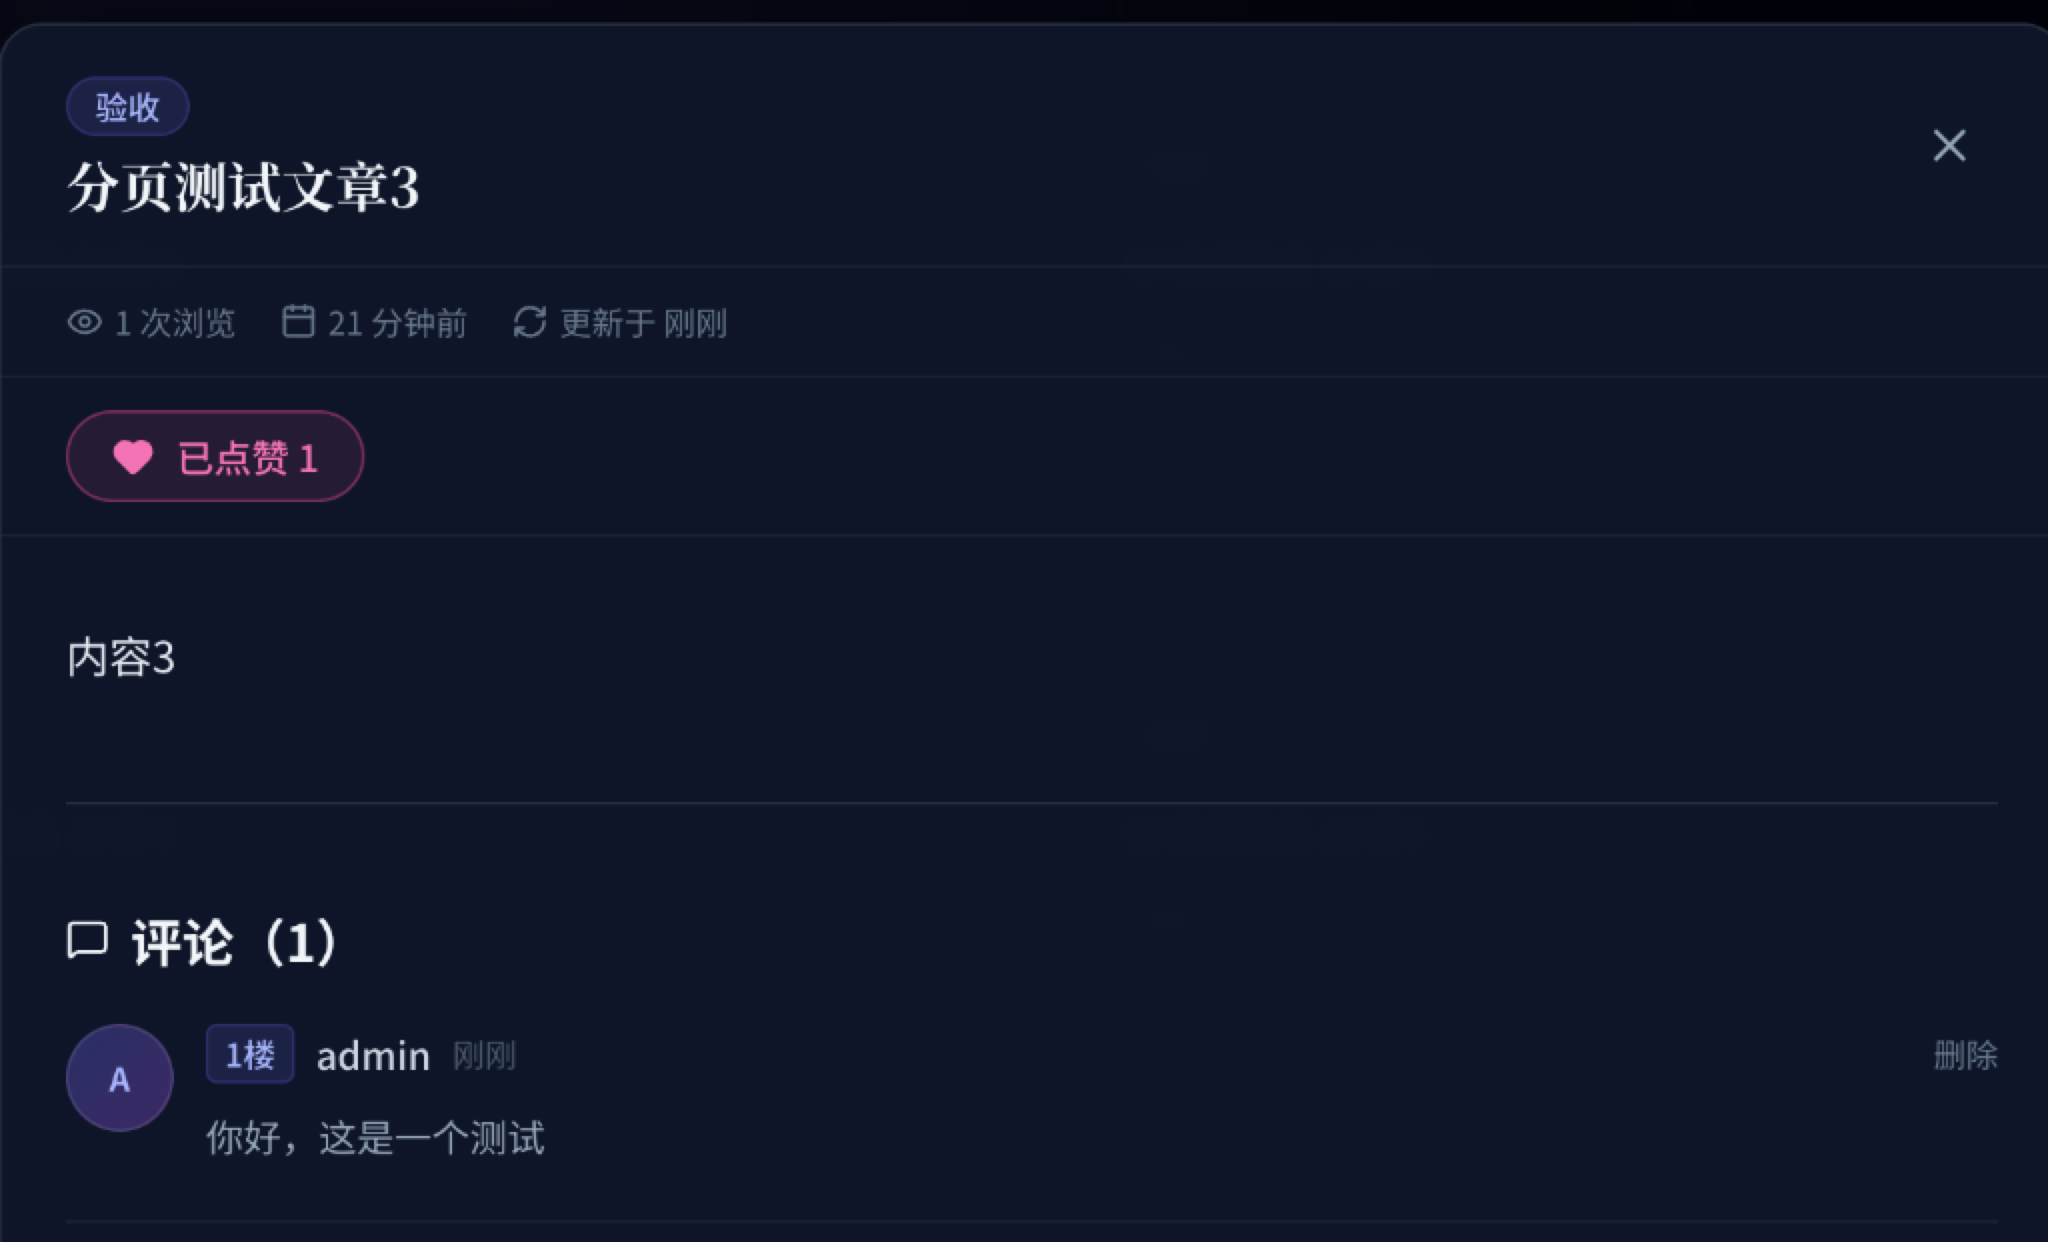
2. 人工上手验收:点赞与楼层评论实测
打开文章阅读器,可以看到文章详情顶部清晰展示 「💖 已点赞 1」 高亮按钮,底部 「💬 评论 (1)」 区域精准渲染了 1楼 admin 刚刚 发表的评论内容与删除按钮:
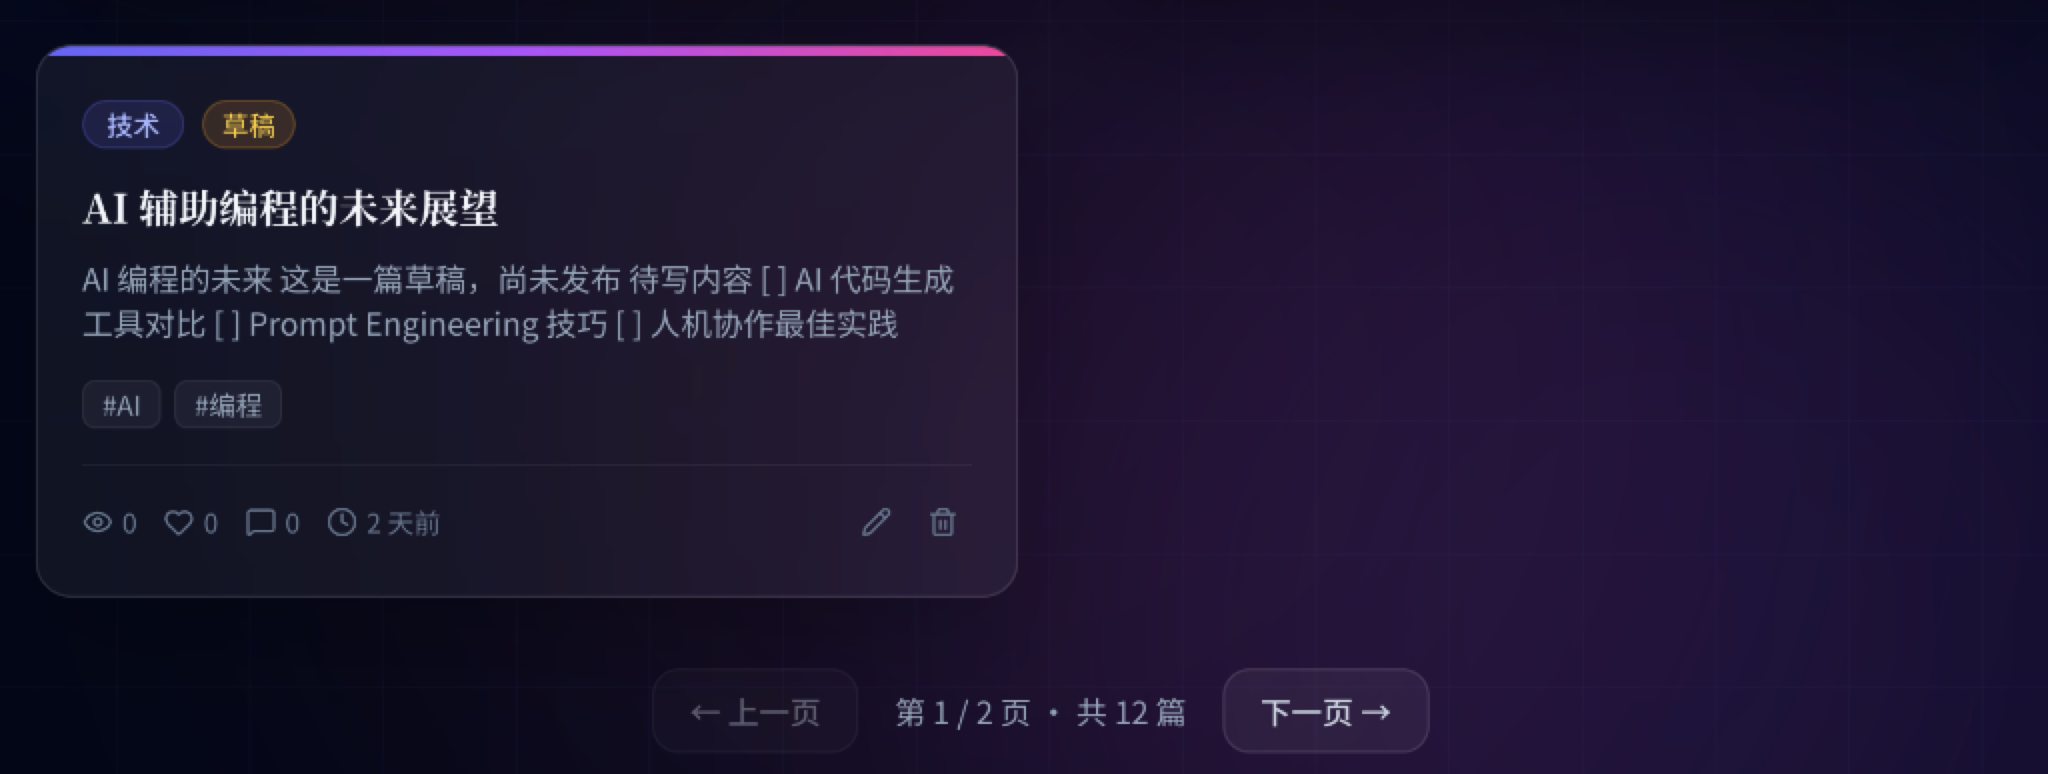
3. 人工上手验收:首页 3×3 分页导航实测
回到首页,底部显示分页控制器:[← 上一页] 第 1 / 2 页 · 共 12 篇 [下一页 →]。继续检查首页、分类列表和搜索结果是否都能正确翻页。
深度复盘:为什么感觉 Solo 模式与普通 Plan 模式的差距变小了?
很多细心的同学在体验完阶段一(Plan 模式)和阶段二(Solo 模式)后,可能会产生一个疑问:
🤔 同学疑惑:“为什么我觉得在咱们这个项目里,普通 Plan 模式和 Solo 模式好像都能很稳地把功能做出来,两者差距并没有想象中那么巨大?”答案非常深刻 —— 并不是 Solo 模式不强,而是我们在项目前期的工程规范设计,主动帮普通模式缩短了与 Solo 模式的差距。

两大缩短差距的秘密武器剖析:
- 🧪 秘诀一:ATDD(验收测试驱动)的帮助:
- 正常来说,普通的非 Solo 对话模式往往容易“写完代码就交差”,不会主动给你补齐严密的测试套件;
- 而我们在项目
.traerules和项目规则中强制注入了 ATDD 红绿测试守卫,这使得哪怕是普通模式也必须先写测试再写业务代码; - 相比之下,Solo 模式原生内置了更强悍的混沌测试(Chaos Testing)与自省修复能力,甚至支持开启多个子智能体协同干活,抗压上限更高。
- 📋 秘诀二:OpenSpec 规格演进与计划先行:
- 我们在动工前坚持先列计划(
docs/保存)并遵循 OpenSpec 的proposal ➔ apply ➔ archive闭环; - 这种严密的规格约束有助于限制修改范围,但仍需验证实现是否符合需求。
- 我们在动工前坚持先列计划(
🌟 模式选择:
- 当你需要精雕细琢、针对关键架构做交互式方案推演时,推荐选择 Plan 模式;
- 当需求和验收条件已经明确,需要连续完成实现、测试和修正时,可以使用 SOLO 模式,并在结束后审查全部差异。
分页和互动功能的边界情况
书店按书架编号找书,如果有人在最前面不断插入新书,后面的编号就会移动。分页列表也会遇到类似情况:连续翻页时有人发布新文章,偏移分页可能出现重复或遗漏。
本例使用页码便于学习,但应至少固定排序,并增加唯一字段作为并列时的排序依据,例如按创建时间和文章编号排序。后续采用游标时,需要说明游标代表什么,以及能否跳到任意页。
评论和点赞还需要处理以下情况:
| 操作 | 应检查的行为 |
|---|---|
| 连点两次点赞 | 不重复计数;并发冲突也得到合理处理 |
| 取消一个尚未点过的赞 | 按约定返回,不出现负数 |
| 删除某页最后一篇文章 | 页面调整到仍存在的页码或显示空状态 |
| 超大页码或非法每页数量 | 明确校验或返回空列表,不无限读取 |
| 评论提交后文章被删除 | 返回可理解的错误,不留下孤立数据 |
唯一约束负责阻止重复记录,接口仍需处理冲突时的事务回滚和响应。它能限制同一用户对同一文章重复点赞,不能单独阻止批量账号刷量。
分页改造还应核对所有调用方。后端把数组改为 {items,total,page,page_size} 后,首页、分类列表和搜索结果若仍按数组读取,就会一起失效。把这些入口列入验收,比只检查新分页按钮更完整。
按重复请求测试互动功能
用户双击按钮、浏览器重试和网络超时都可能让同一请求到达两次。点赞适合用用户与文章的唯一约束保证不重复计数;创建评论是否去重,则要根据产品约定决定,不能直接沿用点赞规则。接口应把冲突转换成稳定响应,而不是把数据库异常原样交给页面。
删除也要沿关联关系检查:删除文章后评论和点赞怎样处理,删除用户后历史内容是否保留,事务失败时是否出现“文章没了但点赞还在”的中间状态。数据库约束与业务代码应保持一致,并通过实际数据验证。
分页回归可准备固定数量的文章,在翻页之间插入或删除一篇,再观察是否重复、遗漏或跳页。若继续使用页码分页,至少保持稳定排序;若改成游标分页,则要同步所有调用方和响应结构,不能只改数据库查询。
本节回顾
互动功能既涉及重复请求,也涉及关联数据;分页则影响所有读取列表的页面。把这些边界一起验收,才能避免只修好一个入口。
继续阅读:6.5 AI 摘要与标签生成。